Anthropic hat Claude Opus 4.7 veröffentlicht, sein derzeit leistungsfähigstes allgemein verfügbares Modell. Was unterscheidet Opus 4.7 von seinem Vorgänger? Auf den ersten Blick handelt es sich um einen fließenden Übergang, doch unter der Oberfläche gibt es eine ganze Reihe von Änderungen.
Der größte Fortschritt wurde im Bereich der Softwareentwicklung erzielt. Nutzer berichten in Tests, dass Opus 4.7 selbst die komplexesten Programmieraufgaben bewältigt, die früher eine kontinuierliche Überwachung erforderten. Das Modell überprüft seine eigenen Ausgaben aktiv, noch bevor es das Ergebnis an den Nutzer zurückgibt.
Bei internen Tests für Programmier- und Agentenaufgaben ermittelte Cursor eine Erfolgsquote von 70 % gegenüber 58 % bei Opus 4.6. Rakuten stellte in seinem SWE-Bench-Benchmark fest, dass Opus 4.7 dreimal so viele produktionsbezogene Aufgaben löst wie das vorherige Modell. Notion Agent wiederum meldet 14 % bessere Ergebnisse bei weniger Token und nur einem Drittel der Fehler bei Werkzeugaufrufen.
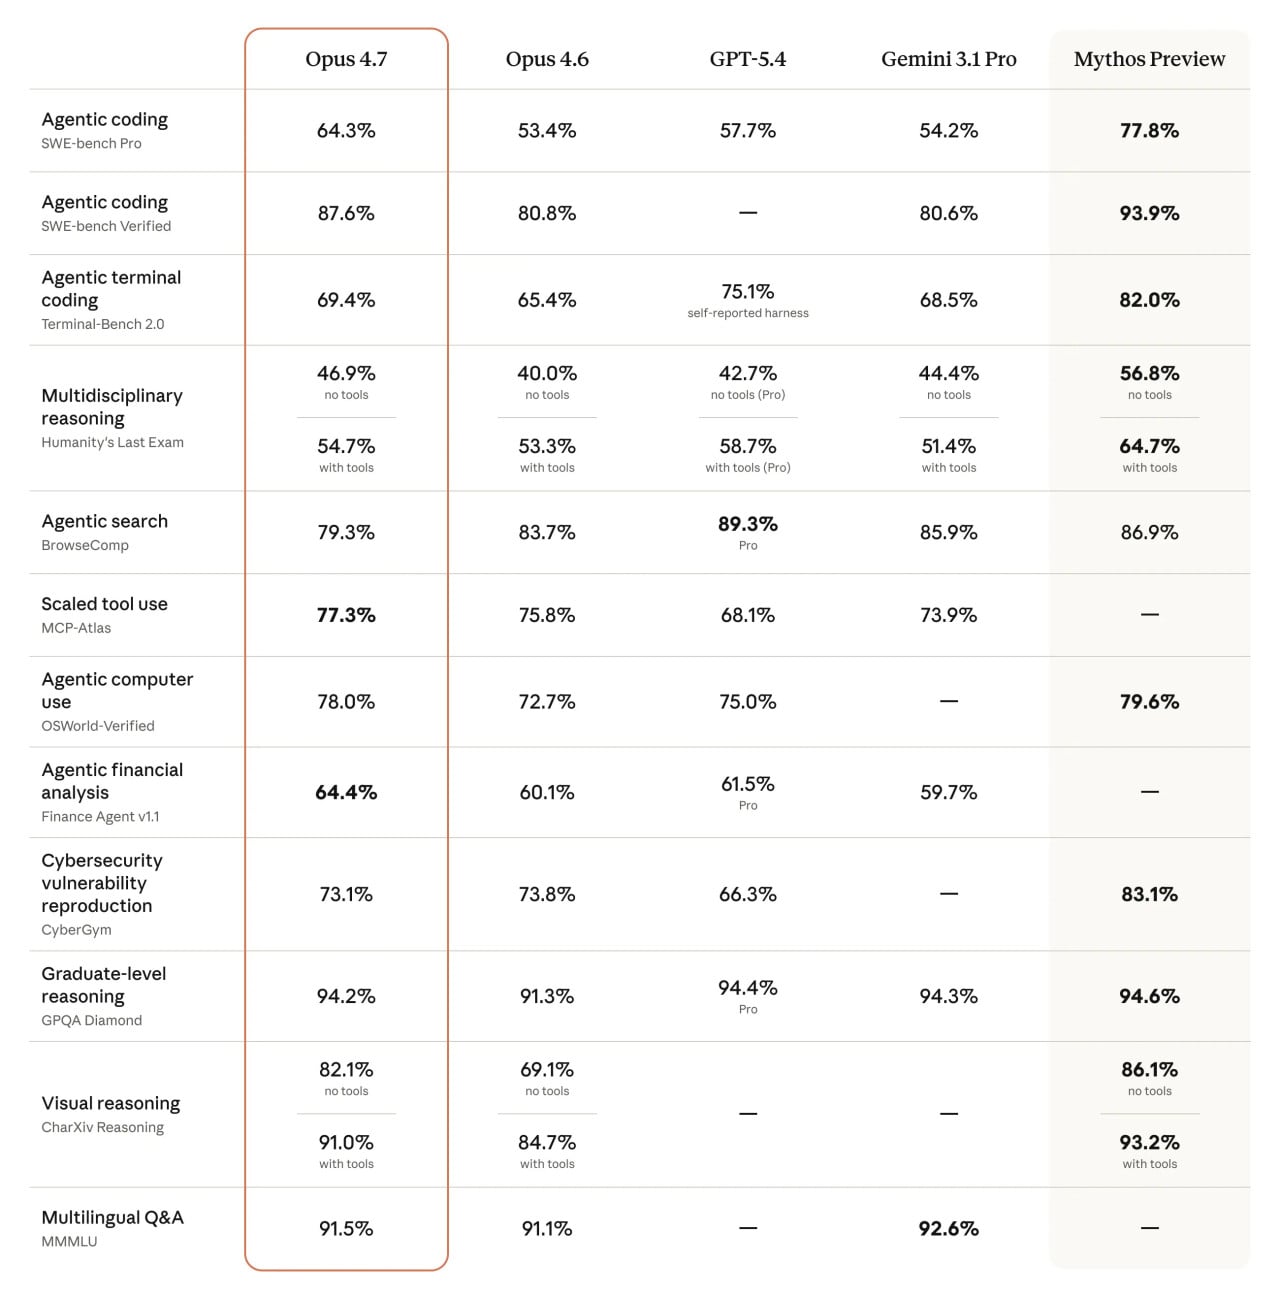
Opus 4.7 bringt den ersten deutlichen Sprung bei der visuellen Wahrnehmung innerhalb der Claude-4-Reihe. Die maximale Bildauflösung wurde auf 2576 Pixel an der längeren Seite erhöht, was etwa 3,75 Megapixeln entspricht. Das ist mehr als das Dreifache des bisherigen Limits. Zudem stimmt das Koordinatensystem des Modells direkt mit den Bildpixeln überein, sodass keinerlei Maßstabsumrechnung mehr erforderlich ist.
In der Praxis eröffnet dies neue Möglichkeiten. Agenten, die mit Computern arbeiten, können detailreiche Screenshots zuverlässig lesen, Daten aus komplexen Diagrammen extrahieren oder mit Dokumenten arbeiten, bei denen jedes Detail zählt. Das Unternehmen XBOW, das Werkzeuge für autonome Penetrationstests entwickelt, ermittelte in seinem Benchmark zur visuellen Genauigkeit 98,5 % gegenüber 54,5 % bei Opus 4.6. Aus seiner Sicht verschwand damit das größte Problem über Nacht.
Besseres Gedächtnis und mehr Sicherheit
Eine neue Fähigkeit von Opus 4.7 besteht darin, dass es besser mit im Dateisystem gespeichertem Wissen arbeitet. Es merkt sich wichtige Notizen über mehrere Sitzungen hinweg und nutzt sie aktiv bei weiteren Aufgaben, anstatt jedes Mal bei null anzufangen. Für Entwickler, die an langfristigen Agentenprojekten arbeiten, bedeutet dies, dass sie den Kontext seltener erneut einrichten müssen. Das Modell führt seine eigenen Arbeitsnotizen mit.
Anthropic weicht in seiner Ankündigung sensiblen Themen nicht aus. In der Woche zuvor veröffentlichte das Unternehmen Project Glasswing, eine Analyse der Risiken und Vorteile künstlicher Intelligenz im Bereich der Cybersicherheit. Opus 4.7 ist das erste Modell, an dem die neuen Schutzmechanismen im realen Betrieb getestet werden.
Das Modell erkennt und blockiert automatisch Anfragen, die mit verbotenen oder hochriskanten Bereichen der Cybersicherheit zusammenhängen. Seine Cyberfähigkeiten erreichen dabei absichtlich nicht das Niveau von Claude Mythos Preview, einem deutlich leistungsfähigeren Modell, dessen Verfügbarkeit Anthropic bislang aus Sicherheitsgründen einschränkt. Beim Training von Opus 4.7 experimentierte das Unternehmen mit einer gezielten Reduzierung dieser Fähigkeiten.
Sicherheitsexperten, die das Modell für legitime Zwecke wie die Erforschung von Schwachstellen oder Penetrationstests benötigen, können über das neue Cyber Verification Program Zugang beantragen.
Was das allgemeine Sicherheitsprofil betrifft, schließt Anthropic die Bewertung mit den Worten ab, das Modell sei „weitgehend gut abgestimmt und vertrauenswürdig, in seinem Verhalten jedoch nicht vollkommen ideal“.
Neue Funktionen für Entwickler
Zusammen mit dem Modell kommen drei Neuerungen auf die Plattform:
Aufwandsstufe xhigh. Opus 4.7 führt eine neue Denkstufe zwischen high und max ein. Entwickler erhalten dadurch eine bessere Kontrolle über den Kompromiss zwischen der Tiefe der Überlegungen und der Antwortgeschwindigkeit. Claude Code legt sie für alle Tarife als Standard fest.
Aufgabenbudgets (Task Budgets) in der Betaversion. Entwickler können Claude mitteilen, wie viele Token es insgesamt für eine einzelne Agentenaufgabe verbrauchen soll. Das Modell sieht den laufenden Countdown und passt seine Vorgehensweise entsprechend an. Es handelt sich nicht um eine exakte Obergrenze, sondern eher um eine Mitteilung an das Modell: So viel Spielraum hast du, teile ihn dir ein.
Befehl /ultrareview in Claude Code. Er startet eine separate Überprüfungssitzung, die Änderungen am Code durchgeht und sowohl Fehler als auch Designprobleme kennzeichnet, die einem sorgfältigen menschlichen Prüfer auffallen würden. Nutzer der Pro- und Max-Tarife erhalten drei kostenlose Ultra-Reviews zum Testen.
Änderungen nach dem Wechsel von Opus 4.6
Anthropic warnt ausdrücklich: Opus 4.7 nimmt Anweisungen wörtlich. Während das ältere Modell Anweisungen frei interpretierte oder Teile übersprang, tut das neue Modell genau das, was Sie ihm sagen – nicht mehr und nicht weniger. Prompts, die für Opus 4.6 geschrieben wurden, können plötzlich unerwartete Ergebnisse liefern. Auch der Tokenizer wurde geändert. Derselbe Text kann beim neuen Modell etwa die 1- bis 1,35-fache Anzahl an Token im Vergleich zum Vorgänger beanspruchen. Der Preis bleibt derselbe wie bei Opus 4.6: 5 Dollar pro Million Eingabe-Token und 25 Dollar pro Million Ausgabe-Token.
Die erweiterten Denkbudgets (Extended Thinking Budgets) aus Opus 4.6 funktionieren überhaupt nicht mehr. Opus 4.7 arbeitet ausschließlich mit adaptivem Denken, das laut internen Tests von Anthropic den ursprünglichen Ansatz zuverlässig übertrifft. Das Modell ist über die API als claude-opus-4-7 sowie auf Amazon Bedrock, Google Cloud Vertex AI und Microsoft Foundry verfügbar.