Das Unternehmen Anthropic stellte am 5. Februar 2026 Claude Opus 4.6 vor, die neueste Version seines leistungsstärksten KI-Modells. Das neue Modell bietet deutliche Verbesserungen beim Programmieren, bei langfristigen agentischen Aufgaben und bei der Arbeit mit umfangreichen Codebasen. Erstmals in der Geschichte der Modelle der Opus-Klasse bietet es in der Beta-Version ein Kontextfenster mit 1 Million Token.
Verbesserte Programmierfähigkeiten
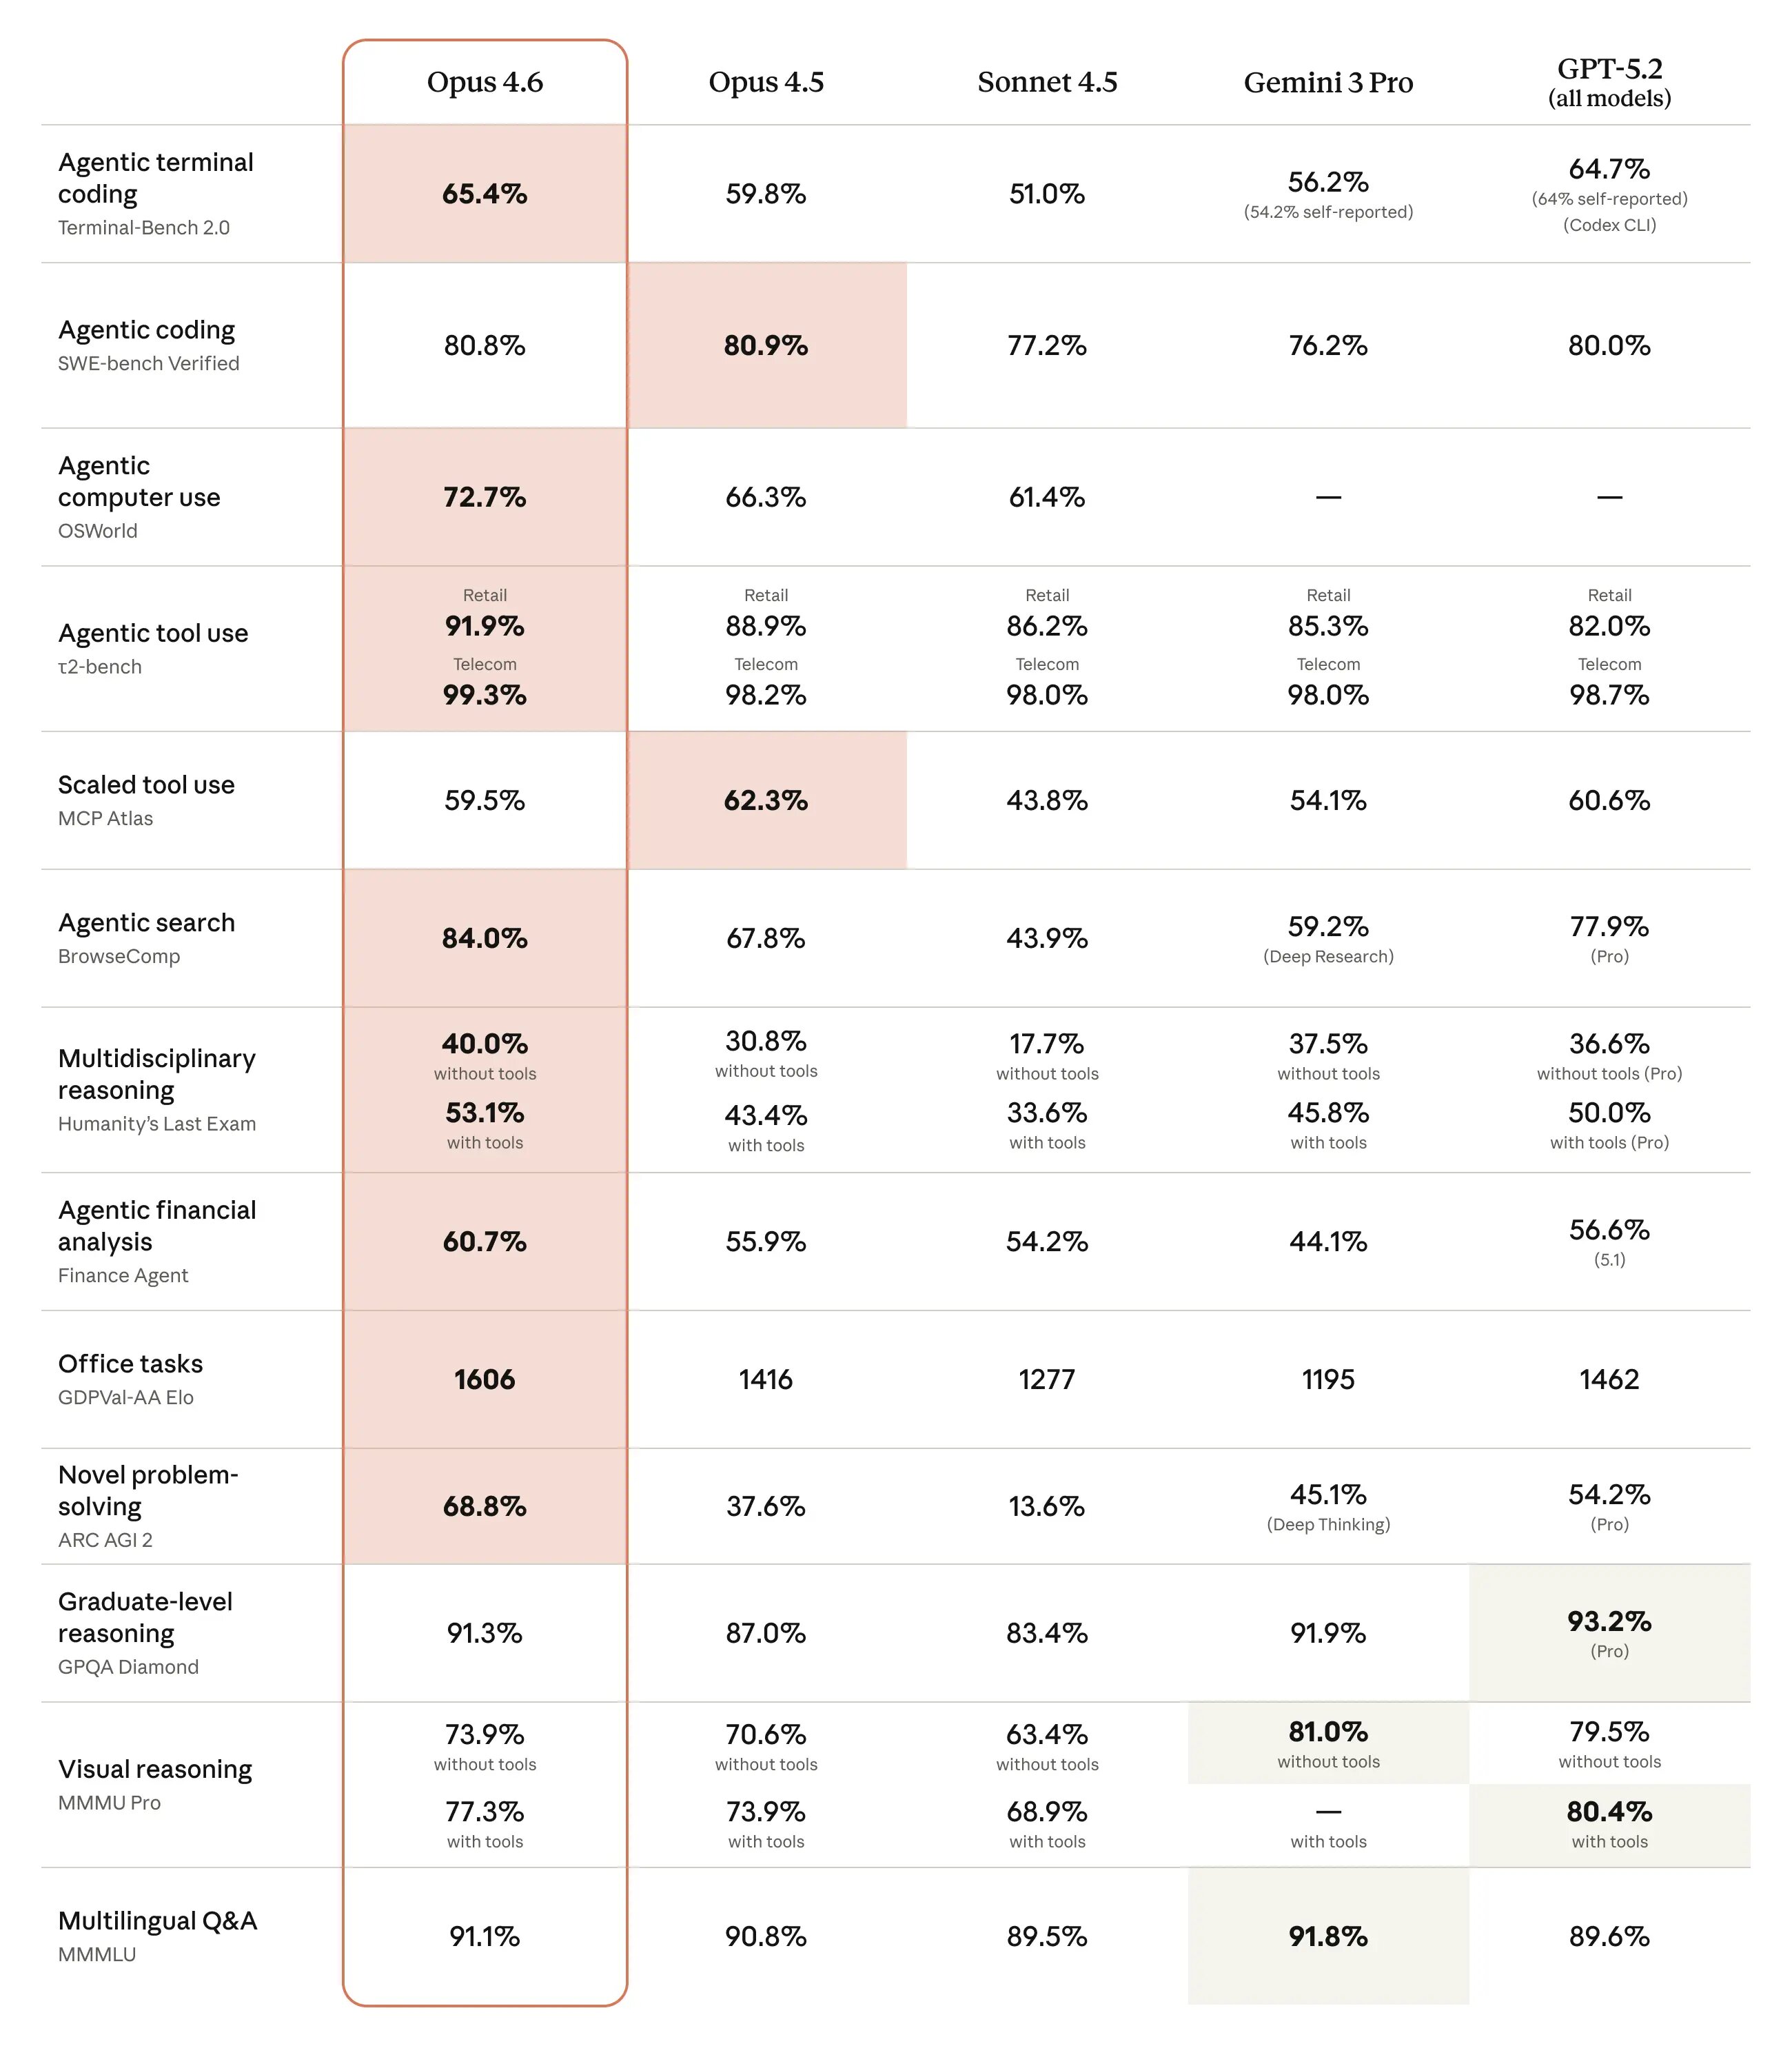
Claude Opus 4.6 zeichnet sich vor allem beim Programmieren aus. Das Modell plant sorgfältiger, kann agentische Aufgaben über längere Zeit aufrechterhalten und arbeitet zuverlässiger in größeren Codebasen. Neu sind verbesserte Fähigkeiten bei Code-Reviews und beim Debugging, wodurch es eigene Fehler erkennen kann. Das Modell erzielte die höchste Punktzahl bei der Bewertung Terminal-Bench 2.0, die agentisches Programmieren testet.
Laut GitHub bewältigt das Modell komplexe, mehrstufige Programmieraufgaben, mit denen Entwickler täglich konfrontiert sind, insbesondere agentische Workflows, die Planung und den Aufruf von Werkzeugen erfordern. Das Unternehmen Replit bestätigte, dass Opus 4.6 einen enormen Sprung bei der agentischen Planung darstellt – es zerlegt komplexe Aufgaben in unabhängige Teilaufgaben, führt Werkzeuge und Subagenten parallel aus und identifiziert Hindernisse mit hoher Genauigkeit.
Dominiert die Leistungstests
Opus 4.6 belegt den ersten Platz im Artificial Analysis Intelligence Index, einer synthetischen Metrik, die 10 Bewertungen zu Fähigkeiten wie agentischen Aufgaben, Programmierung und wissenschaftlichem Schlussfolgern umfasst. Das Modell gewinnt bei drei Evaluierungen: GDPval-AA (agentische Aufgaben in der realen Welt), TerminalBench (agentisches Programmieren und Verwendung des Terminals) und CritPT (Physikprobleme auf Forschungsniveau).
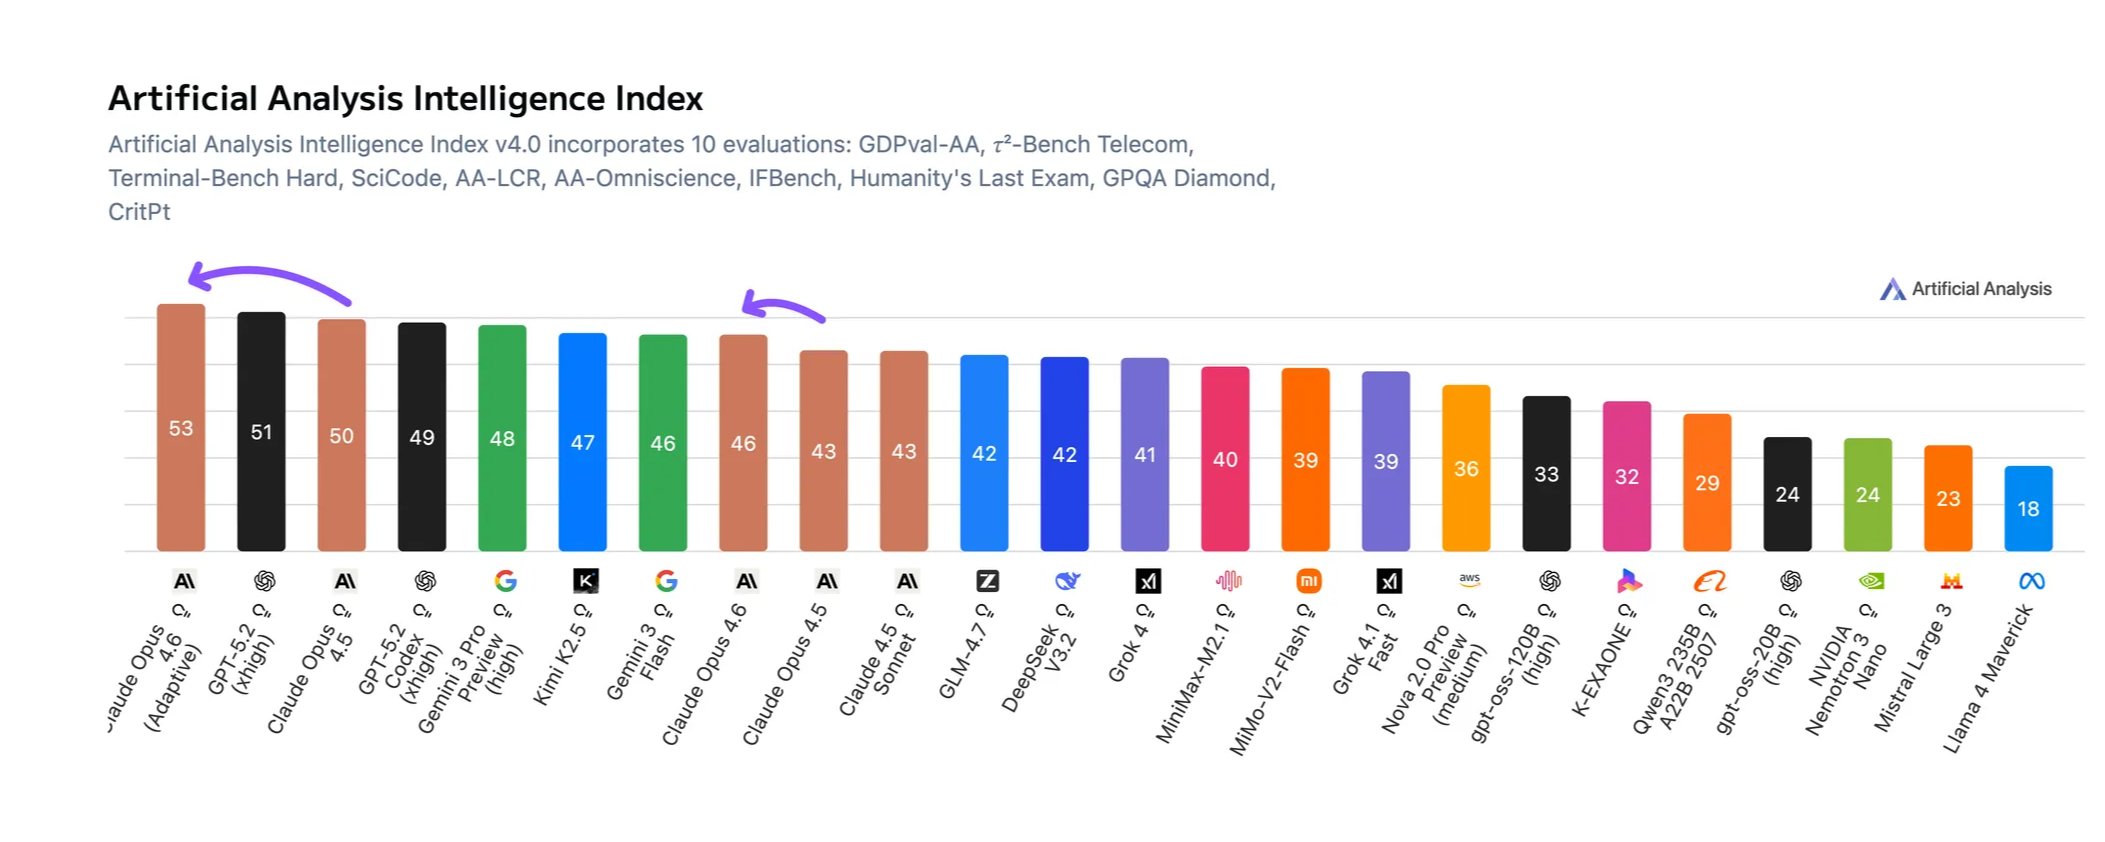
Im Test GDPval-AA, der die Leistung von Modellen bei wissensbasierten Arbeitsaufgaben von der Erstellung von Präsentationen über die Datenanalyse bis hin zur Videobearbeitung misst, übertraf Opus 4.6 GPT-5.2 von OpenAI um etwa 144 Elo-Punkte und seinen Vorgänger Claude Opus 4.5 um 190 Punkte. Das Modell erzielte auch die beste Leistung im Test BrowseComp, der die Fähigkeit eines Modells misst, schwer auffindbare Informationen online zu finden.
Bei Humanity's Last Exam, einem anspruchsvollen multidisziplinären Test des Schlussfolgerungsvermögens, liegt Opus 4.6 vor allen anderen Spitzenmodellen. Im Bereich des wissenschaftlichen Denkens erzielte das Modell mit 13 % die höchste Punktzahl bei CritPT, einer Evaluierung, die aus unveröffentlichten Physikproblemen auf Forschungsniveau besteht.
Arbeit mit langen Kontexten
Opus 4.6 hat seine Fähigkeit, relevante Informationen aus großen Dokumentensammlungen abzurufen, deutlich verbessert. Im Benchmark MRCR v2 (Variante 8-needle 1M), der die Fähigkeit eines Modells testet, in enormen Textmengen „verborgene“ Informationen zu finden, erzielte Opus 4.6 eine Punktzahl von 76 %, während Sonnet 4.5 lediglich 18,5 % erreichte. Dies stellt einen qualitativen Sprung bei der Menge an Kontext dar, die das Modell tatsächlich nutzen kann, ohne dabei an Spitzenleistung einzubüßen.
Eine häufige Beschwerde über KI-Modelle ist der sogenannte „context rot“ (Kontextverfall), bei dem sich die Leistung verschlechtert, sobald eine Unterhaltung eine bestimmte Anzahl von Token überschreitet. Opus 4.6 funktioniert in dieser Hinsicht deutlich besser als seine Vorgänger.
Neue Funktionen und Möglichkeiten
Anthropic führte zusammen mit der Veröffentlichung von Opus 4.6 mehrere wesentliche Änderungen ein. Das Modell bietet einen neuen Modus namens „adaptive thinking“ (adaptives Denken), der den bisherigen Modus „extended thinking“ ersetzt. Anstatt ein Budget für Denk-Token festzulegen, können Entwickler das Denken des Modells nun über die Einstellung „effort“ (Aufwand) mit vier Stufen steuern: niedrig, mittel, hoch und maximal.
Das maximale Ausgabelimit für Token wurde im Vergleich zu Opus 4.5 von 64.000 auf 128.000 Token verdoppelt. Das Modell unterstützt in der Beta-Version außerdem eine neue Funktion namens context compaction (Kontextkomprimierung), die ältere Kontextinhalte automatisch zusammenfasst und ersetzt, wenn sich die Unterhaltung einem konfigurierbaren Grenzwert nähert.
Preis und Verfügbarkeit
Claude Opus 4.6 ist auf der Plattform claude.ai, über die API von Anthropic und auf allen großen Cloud-Plattformen verfügbar, darunter Google Cloud Vertex, AWS Bedrock und Microsoft Azure. Der Preis bleibt derselbe wie bei Opus 4.5: 125 Kč pro Million Eingabe-Token und 625 Kč pro Million Ausgabe-Token.
Laut einer Analyse von Artificial Analysis kostete die Ausführung des Intelligence Index mit Opus 4.6 im Modus für adaptives Denken bei maximalem Aufwand 62.150 Kč (2.486 US-Dollar), was mehr ist als bei GPT-5.2 (xhigh) von OpenAI, das 57.600 Kč (2.304 US-Dollar) kostete. Das Modell verwendete jedoch deutlich weniger Token als die Konkurrenz – 58 Millionen Ausgabe-Token, was etwa doppelt so viel ist wie bei Opus 4.5, aber deutlich weniger als bei GPT-5.2 mit xhigh reasoning effort (130 Millionen).
Sicherheit und Zuverlässigkeit
Laut der umfangreichen Systemkarte von Anthropic weist Opus 4.6 ein allgemeines Sicherheitsprofil auf, das ebenso gut oder besser ist als das jedes anderen führenden Modells der Branche, mit geringen Raten von Fehlverhalten in allen Sicherheitsevaluierungen. Das Modell weist außerdem die niedrigste Ablehnungsrate (over-refusals) aller neueren Claude-Modelle auf, bei denen das Modell harmlose Anfragen nicht beantworten kann.
Das Unternehmen Notion erklärte, dass Opus 4.6 das leistungsstärkste Modell sei, das Anthropic veröffentlicht hat. Es nimmt komplexe Anforderungen auf und führt sie tatsächlich zu Ende, unterteilt sie in konkrete Schritte, setzt diese um und liefert eine ausgefeilte Arbeit, selbst wenn die Aufgabe ambitioniert ist. Das Unternehmen Asana bestätigte, dass Opus 4.6 das beste Modell ist, das es bisher getestet hat, mit außergewöhnlichen Fähigkeiten beim Schlussfolgern und Planen.