BBC und New York Times kämpfen gegen das KI-Startup Perplexity wegen der unerlaubten Nutzung von Artikeln
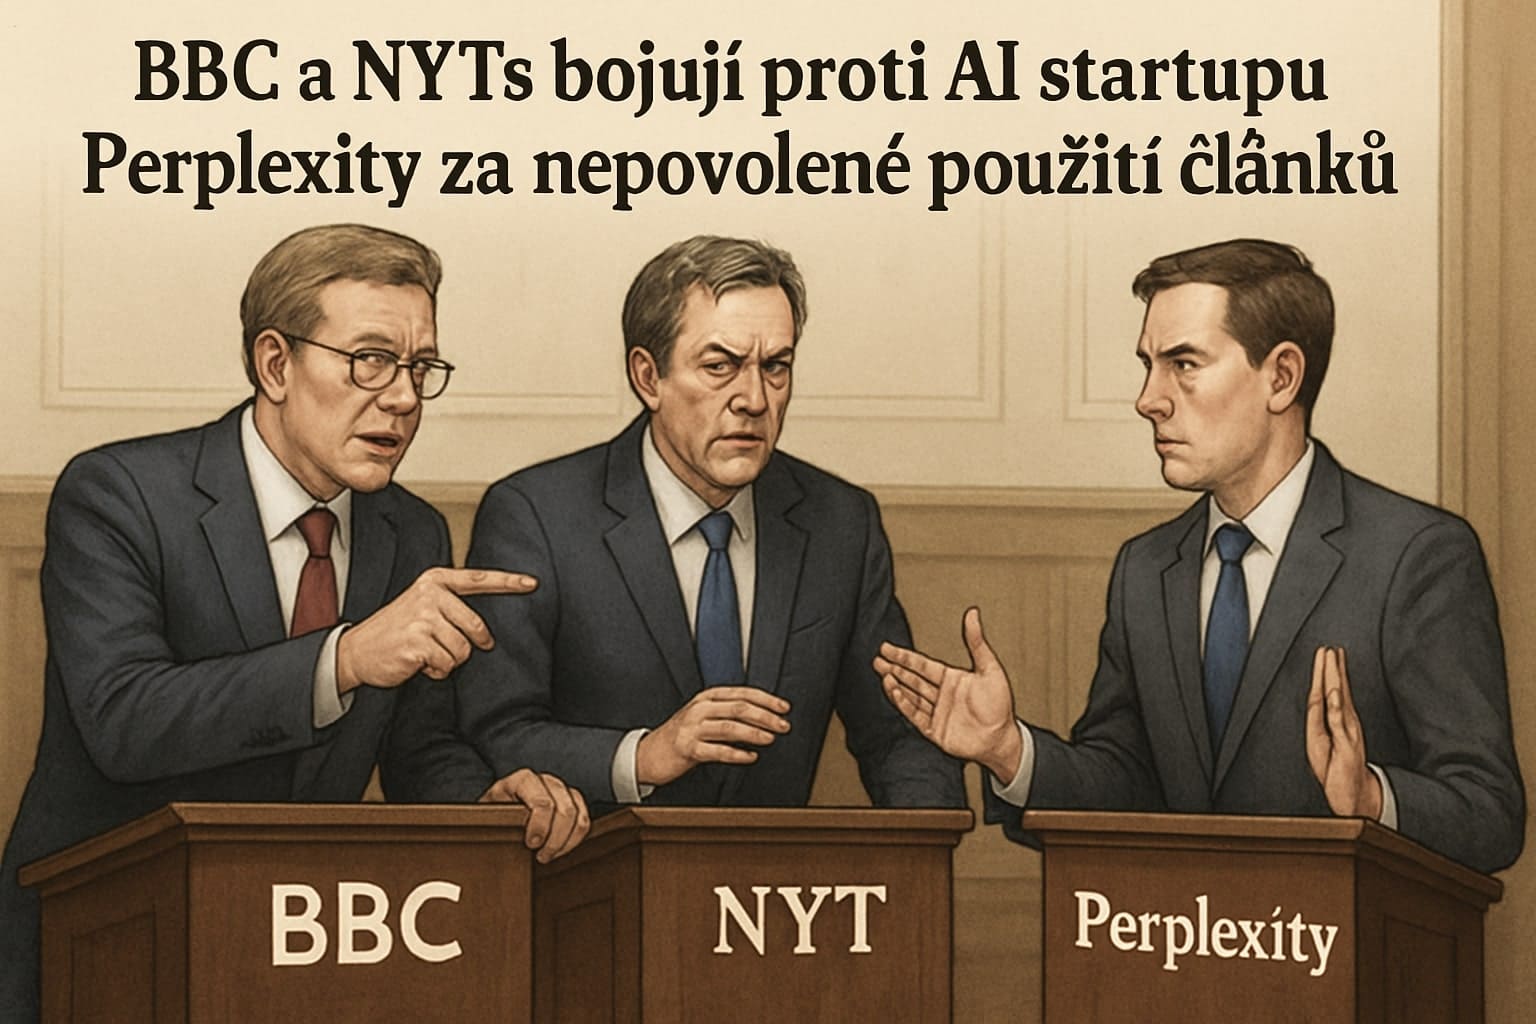
Künstliche Intelligenz und die Medienwelt geraten in immer schärfere Konfrontationen. Das jüngste Kapitel dieses Konflikts spielt sich zwischen den renommierten Medienhäusern BBC und New York Times auf der einen Seite und dem KI-Startup Perplexity auf der anderen Seite ab.
BBC droht mit einer Klage
Die BBC, der öffentlich-rechtliche Rundfunk Großbritanniens, schickte dem KI-Startup Perplexity im Juni 2025 eine rechtliche Drohung in Form eines an den CEO des Unternehmens, Aravind Srinivas, gerichteten Schreibens. Laut einem Bericht der Financial Times wirft die BBC Perplexity vor, Inhalte der BBC ohne Genehmigung zum Trainieren seiner KI-Modelle zu verwenden. In dem Schreiben fordert die BBC Perplexity auf, das Scraping (Auslesen) ihrer Inhalte unverzüglich einzustellen, alle vorhandenen Kopien zu löschen, die zum Trainieren von KI-Systemen verwendet werden, und einen „Vorschlag für eine finanzielle Entschädigung“ für die mutmaßliche missbräuchliche Nutzung geistigen Eigentums vorzulegen. Sollte das Unternehmen diesen Forderungen nicht nachkommen, erwägt die BBC, eine gerichtliche Verfügung zu beantragen.
Der britische Sender bestätigte den Bericht der Financial Times in einer Erklärung gegenüber der Nachrichtenagentur Reuters und erklärte, dass Teile seiner Inhalte von Perplexity wörtlich wiedergegeben worden seien und Links zu den Websites der BBC in den Suchergebnissen erschienen seien.
Vorwurf des wörtlichen Kopierens
Die BBC behauptet, dass die KI-Antworten von Perplexity häufig BBC-Materialien wörtlich wiedergeben, einschließlich ganzer Passagen und Überschriften, oft ohne Quellenangabe oder ordnungsgemäße Lizenzierung. Nach Ansicht der BBC untergräbt diese Praxis ihre Rechte am geistigen Eigentum und ihr Geschäftsmodell, da sich Leser auf KI-generierte Antworten verlassen könnten, anstatt die Plattformen der BBC direkt zu besuchen.
Perplexity weist die Vorwürfe zurück
Perplexity AI wies die Behauptungen der BBC entschieden zurück und bezeichnete die Beschwerde als „manipulativ und opportunistisch“. In einer Erklärung gegenüber Reuters erklärte das Unternehmen, die BBC habe ein „grundlegendes Missverständnis von Technologie, Internet und dem Recht des geistigen Eigentums“.
Perplexity argumentiert, dass seine KI-Modelle öffentlich zugängliche Informationen auf eine Weise nutzen, die das Unternehmen als mit rechtlichen Normen und Transparenz vereinbar ansieht. Das Unternehmen behauptet, die BBC versuche, den Wettbewerb zu unterdrücken und die Dominanz der etablierten Technologiegiganten bei der digitalen Suche aufrechtzuerhalten.
Frühere Konflikte mit der New York Times
Die BBC ist nicht das einzige Medienhaus, das den Kampf gegen Perplexity aufgenommen hat. Bereits im Oktober 2024 schickte die New York Times Perplexity eine Unterlassungsaufforderung („cease and desist“), in der sie verlangte, dass das Unternehmen die Nutzung von Zeitungsinhalten für generative KI einstellt.
In einem auf den 2. Oktober 2024 datierten Schreiben forderte die New York Times das KI-Unternehmen auf, „jeglichen gegenwärtigen und zukünftigen unbefugten Zugriff auf Inhalte der Times sowie deren Nutzung unverzüglich einzustellen und zu unterlassen“. Die Zeitung forderte Perplexity außerdem auf, Informationen darüber bereitzustellen, wie das Unternehmen trotz der Präventionsmaßnahmen des Verlags auf dessen Websites zugreift.
Perplexity hatte dem Verlag zuvor versichert, dass es die „Crawling“-Technologie (Durchsuchen des Webs) nicht mehr einsetzen werde, doch laut dem Schreiben erscheinen Inhalte der NYT weiterhin bei Perplexity. Das Unternehmen reagierte darauf mit der Erklärung: „Wir sammeln keine Daten zum Aufbau von Basismodellen, sondern indexieren Websites und veröffentlichen sachliche Inhalte als Quellenangaben, um Antworten zu untermauern, wenn ein Nutzer eine Frage stellt.“
Spannungen zwischen Journalisten und KI
Dieser Streit verdeutlicht die wachsenden Spannungen in der Branche zwischen Medienorganisationen und KI-Unternehmen. Seit der Einführung von ChatGPT warnen Verlage vor Chatbots, die das Internet durchsuchen, Informationen finden und für Nutzer Zusammenfassungen von Absätzen erstellen können.
Da sich KI-Modelle beim Training zunehmend auf frei zugängliche Webinhalte stützen, befürchten Medienunternehmen systematische Verletzungen des geistigen Eigentums, die ihre Besucherzahlen und Einnahmen beeinträchtigen könnten. Während KI-Unternehmen häufig behaupten, ihre Nutzung falle unter „Fair Use“ (angemessene Verwendung), argumentieren Nachrichtenorganisationen, dass wörtliche Wiedergaben ihre Rechte und ihre langfristige Tragfähigkeit gefährden.
Weitere Konflikte mit Medienorganisationen
Perplexity sah sich auch mit Plagiatsvorwürfen von Medienorganisationen wie Forbes und Wired konfrontiert. Als Reaktion auf diese Bedenken der Verlage startete das Unternehmen ein Programm zur Umsatzbeteiligung, das einige der von den Verlagen angesprochenen Probleme lösen soll.
Die New York Times führt zudem einen Rechtsstreit gegen OpenAI, das sie Ende vergangenen Jahres verklagte und beschuldigte, Millionen von Zeitungsartikeln ohne Genehmigung zum Trainieren ihres KI-Chatbots verwendet zu haben. Anfang dieses Jahres berichtete Reuters, dass mehrere KI-Unternehmen einen von Verlagen eingesetzten Webstandard umgehen, der das Scraping ihrer in generativen KI-Systemen verwendeten Daten blockieren soll.