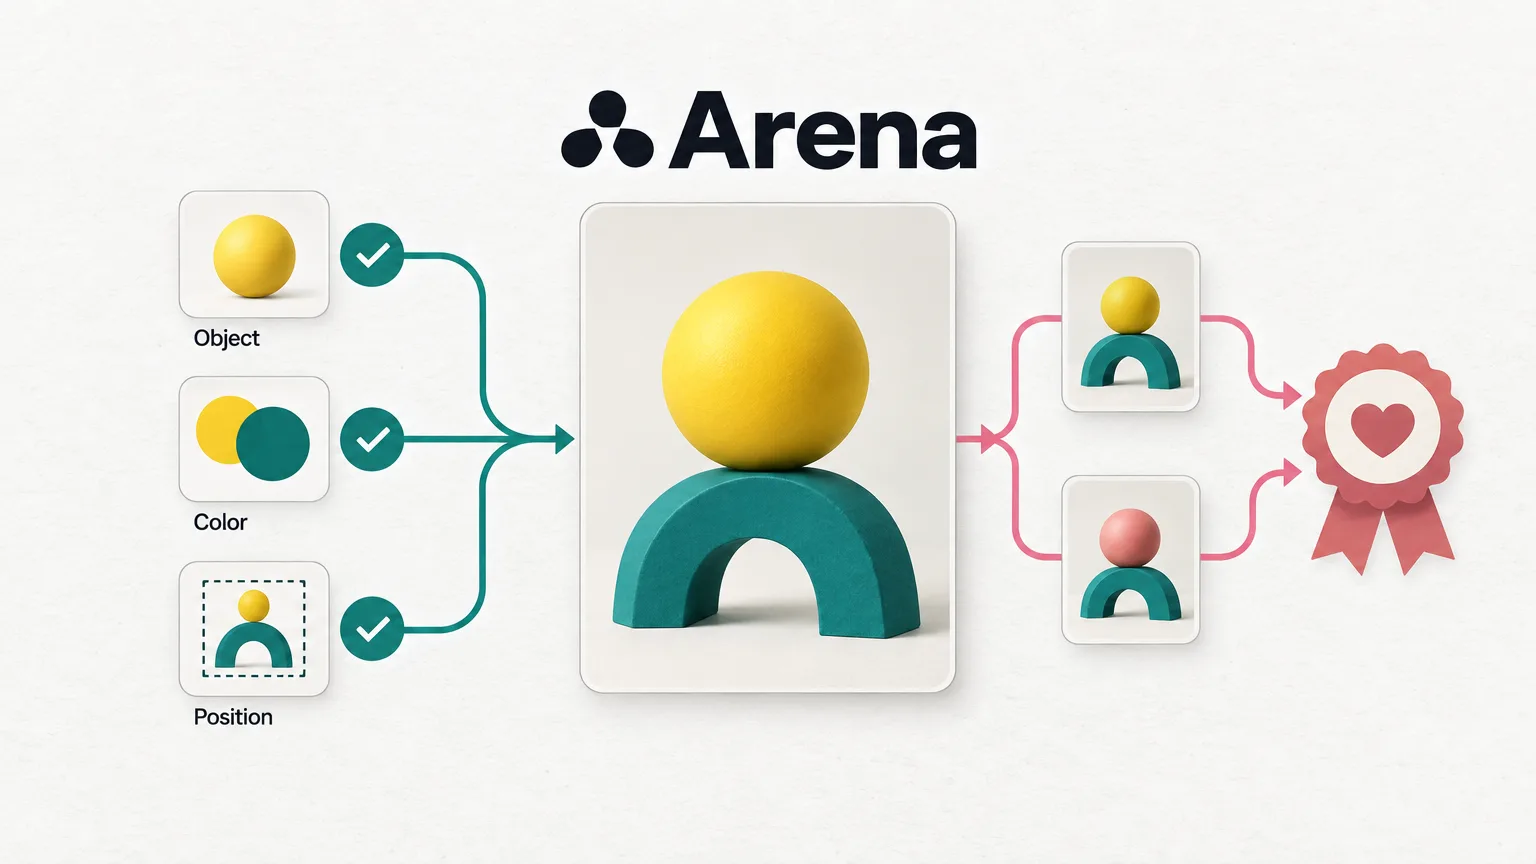
Arena hat ein Verfahren zum Nachtraining von Text-zu-Bild-Modellen veröffentlicht, das die Bewertung menschlicher Präferenzen mit einer Prüfung konkreter Prompt-Anforderungen verbindet. Angewandt wurde es auf FLUX.2-dev und Ideogram 4. Beim Training bewertet die Methode neben der visuellen Gestaltung auch, ob gewünschte Objekte, ihre Eigenschaften und ihre Beziehungen zueinander im Bild enthalten sind.
Prüffragen zu jedem Trainingsprompt ergänzen menschliche Präferenzen
Die Präferenzbewertung beruht auf einem Bradley–Terry-Modell, das Arena nach eigenen Angaben mit rund fünf Millionen menschlichen Stimmen trainiert hat. Die Daten stammen aus paarweisen Vergleichen der Ausgaben von mehr als 100 Modellen in der Text-to-Image Arena. Das Bewertungsmodell schätzt, welches von zwei Bildern ein Mensch bevorzugen würde, und bildet daraus einen Wert für visuelle Qualität, Komposition und Ästhetik.
Daneben bewertet Arena für jeden Trainingsprompt gesondert, wie genau das Bild die Vorgaben erfüllt. Ein Sprachmodell zerlegt die Anforderung zunächst in einen Baum konkreter Ja-Nein-Fragen. Diese betreffen Objekte und deren Eigenschaften sowie räumliche Beziehungen und den gewünschten Stil. Anschließend prüft ein visuell-sprachliches Modell das erzeugte Bild; der Anteil erfüllter Kriterien bestimmt die Belohnung.
Laut Arena helfen die Einzelbewertungen auch dabei, Fehler während des Trainings aufzuspüren. Die Checkliste zeigt, welche nicht erfüllte Vorgabe die Belohnung für ein Bild verringert hat: etwa weil ein Objekt fehlt, eine Eigenschaft nicht stimmt oder eine räumliche Beziehung falsch dargestellt ist.
Strengere Prüfungen richten sich nach der Absicht des Prompts
Ein weiterer Bestandteil des Arena-Verfahrens prüft Inhalte, die der Absicht des Nutzers widersprechen. Dazu gehören unerwünschte Objekte, Abweichungen vom geforderten Stil und Verstöße gegen negative Anweisungen, also Vorgaben dazu, was das Bild nicht enthalten soll. Arena aktiviert diese Prüfung nur bei Prompts, die eine strikte Einhaltung verlangen; bei kreativen Anforderungen bleibt mehr Spielraum.
Ein Detektor begrenzt die Belohnung bei bekannten Fehlern
Ein separater Detektor sucht im Trainingsverfahren von Arena nach bekannten Formen des Reward Hacking, also der Umgehung des Belohnungssystems. Dazu zählen entstellter Text und eine unerwünschte Verschiebung hin zu fotografischer Darstellung. Er vergibt keine zusätzlichen positiven Punkte, sondern greift bei als problematisch erkannten Ausgaben in den Präferenzwert ein.
Bei einem so markierten Bild begrenzt Arena den Präferenzwert auf höchstens null, sodass Ästhetik oder Komposition keine positive Präferenzbelohnung einbringen können. Bei allen anderen Trainingsbeispielen bleibt der ursprüngliche Wert unverändert.
Diese Prüfung erfasst nur die dokumentierten Fehlertypen. Neue Formen der Belohnungsumgehung erfordern zusätzliche Kriterien oder neue Detektoren.
Model Soups führt Varianten zu einem einzigen Modell zusammen
Arena beschreibt außerdem das Training mehrerer Varianten mit unterschiedlichen Belohnungskonfigurationen. Alle starten vom selben Modell-Checkpoint. Mit der Methode Model Soups werden anschließend ihre Parameteränderungen gegenüber dieser gemeinsamen Basis gemittelt, statt bei der Bilderzeugung mehrere Modelle parallel auszuführen.
Laut Arena hält der gemeinsame Ausgangs-Checkpoint die Parameteränderungen aufeinander abgestimmt. Durch die Zusammenführung entsteht ein einziges Modell, ohne zusätzliche Ensemble-Kosten bei der Bilderzeugung. Ihr zufolge lässt sich das Verfahren auch mit Open-Source-Belohnungsmodellen wie Pickscore einsetzen.
Ergebnisse gegenüber dem Basismodell und in der Live-Rangliste
Arena verwendete 10 000 echte Nutzerprompts für das Training und reservierte weitere 1 000 für die Auswertung. Im Offline-Test fungierte Gemini-3.5-Flash als Bewerter und verglich jede nachtrainierte Ausgabe mit der Ausgabe des eingefrorenen Basismodells. Die Bildpaare wurden in beiden Präsentationsreihenfolgen bewertet, um den Einfluss der Reihenfolge zu verringern.
In dieser automatisierten Bewertung gewann die Konfiguration mit Prüfungen, die von der Absicht des Prompts abhängen, laut Arena 64,2 % der Vergleiche mit dem Basismodell. Nach der Zusammenführung der Parameter stieg der Anteil auf 66,0 %, ein Plus von 1,8 Prozentpunkten. Die Entscheidungen in diesem Test traf Gemini, nicht menschliche Abstimmende.
Für ihre Live-Rangliste, die menschliche Stimmen aus paarweisen Vergleichen nutzt, meldet Arena einen Zuwachs von 69 Arena-Punkten für den nachtrainierten FLUX.2-dev. Der nachtrainierte Ideogram 4 erreichte nach ihren Ergebnissen 1 224 Punkte und lag am 4. September 2026 vor allen öffentlich gelisteten Open-Source-Modellen dieser Rangliste.
Die beschriebenen Ergebnisse decken zwei Basismodelle ab. Die Werte der Live-Rangliste können sich durch zusätzliche menschliche Stimmen und neu hinzukommende Konkurrenzmodelle ändern.