Anthropic hat Claude Haiku 5.5 veröffentlicht, ein neues kleines Modell für die Verarbeitung großer Aufgabenvolumen. Erstmals in der Haiku-Reihe können Nutzer den Rechenaufwand einstellen und zwischen einem sparsameren Betrieb und höherer Leistungsfähigkeit wählen. Mit der Veröffentlichung erweitert das Unternehmen seine Entwickler-SDKs um Beta-Unterstützung für die Computer- und Browsersteuerung.
Wiederkehrende Aufgaben und Hilfsagenten beim Programmieren
Anthropic sieht Haiku 5.5 vor allem für schnelle, wiederkehrende Arbeiten vor. Zu den empfohlenen Aufgaben gehören Zusammenfassungen und die Verdichtung des Kontexts. Weitere Einsatzbereiche sind Datenbankabfragen und Klassifizierungen. Beim Programmieren kann das Modell dem Unternehmen zufolge als untergeordneter Agent für Opus 5.5 oder Sonnet 5.5 arbeiten.
Für zeitkritische Aufgaben empfiehlt Anthropic das Modell außerdem im Live-Kundensupport und zur Browsersteuerung. Das Unternehmen bezeichnet es als sein bislang schnellstes Modell, wenn jeweils die Standardgeschwindigkeit verglichen wird; die Opus-Modelle laufen laut Anthropic im Fast Mode allerdings schneller.
Computersteuerung im Test OSWorld 2.1
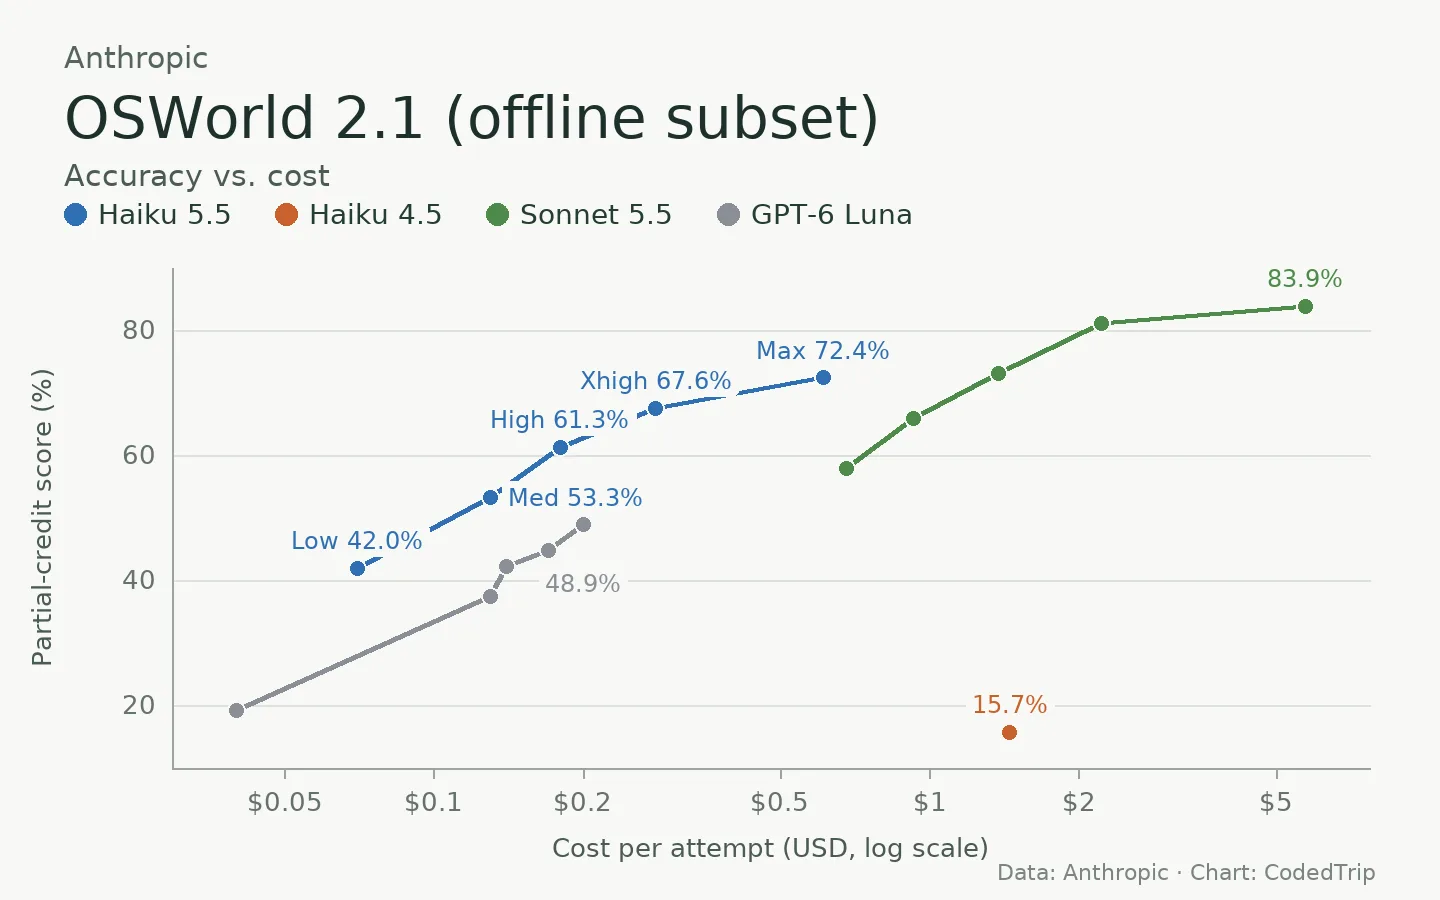
Im von Anthropic veröffentlichten Vergleich erreicht Haiku 5.5 in der Offline-Teilmenge von OSWorld 2.1 einen Wert von 72,4 %, während der Vorgänger Haiku 4.5 auf 15,7 % kommt. Das Unternehmen beschreibt den Benchmark als Test dafür, wie gut Agenten einen realen Computer bedienen, um lange Aufgaben mit mehreren Schritten zu erledigen.
Im selben Vergleich weist Anthropic für GPT-6 Luna einen Wert von 48,9 % aus. Haiku 5.5 liegt in dieser Offline-Teilmenge darüber, bleibt aber hinter Sonnet 5.5 mit 83,9 % zurück.
Wissensarbeit und Grenzen bei komplexer Programmierung
Auch beim Benchmark GDPval-AA v2.1 zeigt Anthropics veröffentlichter Vergleich einen höheren Wert als beim Vorgänger: Haiku 5.5 erreicht 1620 Punkte, Haiku 4.5 kommt auf 735. GPT-6 Luna erzielt in diesem Test 1437 Punkte, das als Referenz aufgeführte Sonnet 5.5 erreicht 1840.
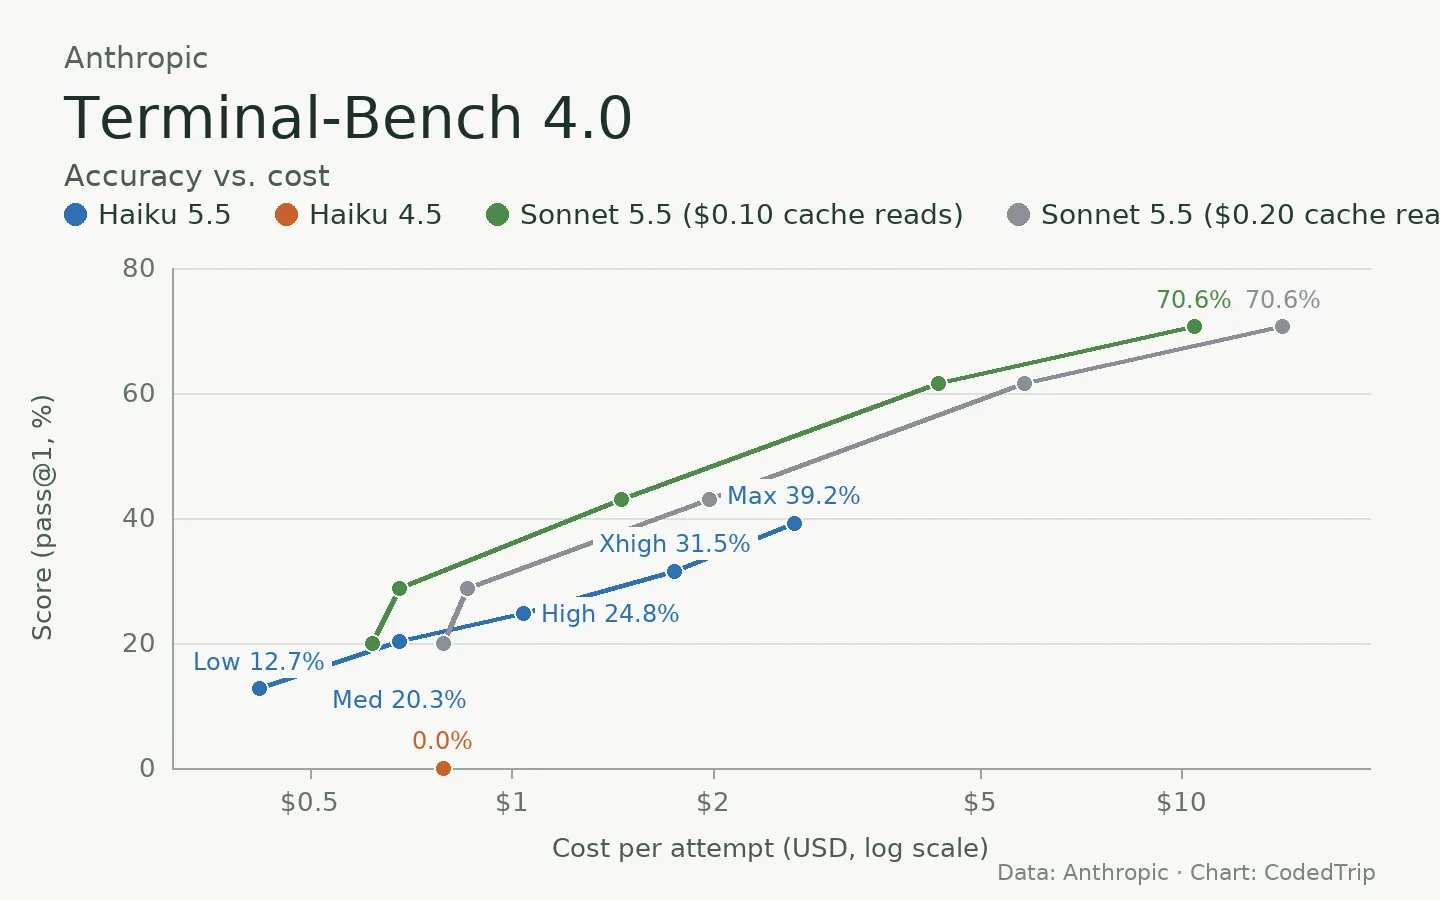
Für Programmieragenten nennt Anthropic Ergebnisse aus Terminal-Bench 4.0. Dieser Test bewertet laut dem Unternehmen, wie gut Modelle komplexe berufliche Aufgaben mit mehreren Schritten in einer Kommandozeilenumgebung abschließen. Haiku 5.5 erreicht hier 39,2 %, gegenüber 0,0 % bei Haiku 4.5 und 16,4 % bei GPT-6 Luna; Sonnet 5.5 kommt auf 70,6 %.
Für komplexe agentische Programmieraufgaben empfiehlt Anthropic daher weiterhin Sonnet 5.5 und Opus 5.5. Haiku eignet sich nach Einschätzung des Unternehmens besser für enger abgegrenzte Aufgaben.
| Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 For reference | |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 | 72.4% Offline subset | 15.7% Offline subset | 48.9% Offline subset | 83.9% Offline subset |
| Humanity’s Last Exam | 45.9% no tools | 10.2% no tools | — | 56.9% no tools |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (Main) | 46.4% | — | 42.4% | 52.1% Xhigh |
| Chartography | 46.4% no tools | 6.4% no tools | 29.1% no tools | 61.6% no tools |
Verfügbarkeit in Clouds und Beta-Unterstützung in den SDKs
Claude Haiku 5.5 ist auf allen Plattformen verfügbar, darunter Amazon Web Services, Google Cloud und Microsoft Azure. Auf der Claude Platform können Entwickler das Modell unter der Kennung claude-haiku-5-5 nutzen.
Die Aktualisierung der Claude-SDKs für Python und TypeScript ergänzt die Unterstützung für Computer- und Browsersteuerung als Beta.
Laut Anthropic ist der Betrieb im Durchschnitt rund 75 % günstiger als bei Haiku 4.5: Die Listenpreise liegen für Anfragen bis 100.000 Token, auf die beim Vorgänger 90 % der Anfragen entfielen, um 90 % niedriger und oberhalb dieser Grenze um 50 %, wobei die Durchschnittsberechnung den neuen Tokenizer berücksichtigt, durch den Haiku 5.5 für dieselbe Arbeit etwas mehr Token benötigt.
Einschränkungen bei Cybersicherheits- und Biologieaufgaben
Laut Anthropic sind die Schutzmechanismen für Cybersicherheit strenger als bei Haiku 4.5, erlauben aber ein breiteres Spektrum defensiver Aufgaben als die von Sonnet 5.5. Sie blockieren weiterhin Penetrationstests und andere Techniken, bei denen das Unternehmen einen Missbrauch durch Angreifer für wahrscheinlicher hält.
In der Biologie gelten dem Unternehmen zufolge dieselben Schutzmechanismen wie bei Sonnet 5, Sonnet 5.5 und Opus 5: Forschungsfragen sind erlaubt, als wahrscheinlich schädlich eingestufte Anfragen werden eingeschränkt. Organisationen mit weitergehenden Anforderungen in Biologie oder Cybersicherheit können sich für die Teilnahme am Life Sciences Verification Program und am Cyber Verification Program bewerben.