Anthropic hat gemeinsam mit Theorem Claude eingesetzt, um Fehler zu beheben und formale Beweise für 239 Test-Einstiegspunkte in 123 Open-Source-Bibliotheken aus OSS-Fuzz zu erstellen. Laut dem Unternehmen dauerte die Arbeit einige Wochen. Die Beweise zeigen, dass ausgewählte Tests unter festgelegten Bedingungen bei keiner Eingabe unter 64 MB abstürzen – statt lediglich viele einzelne Testfälle erfolgreich zu durchlaufen.
Von Fuzz-Tests zu mathematischen Spezifikationen
Ausgangspunkt waren vorhandene Fuzz-Tests, bei denen Programme mit veränderten Eingaben auf Fehler geprüft werden. Anthropic überführte sie nach eigenen Angaben in mathematische Spezifikationen über die kompilierten RISC-V-Instruktionen. Claude sollte nicht weitere einzelne Testfälle ausprobieren, sondern beweisen, dass der jeweilige Test bei keiner Eingabe unterhalb der festgelegten Größenbegrenzung abstürzt.
Laut Anthropic entstanden rund 180 Millionen Zeilen im formalen Beweissystem Rocq. Ein typischer Beweis umfasste etwa 600.000 Zeilen; die Länge der überprüften Binärprogramme lag im Median bei 18.000 RISC-V-Instruktionen. Zur Übertragung des Maschinencodes in ein mathematisches Modell nutzte das Projekt Theorems formale Beschreibung der RISC-V-Instruktionen und Linux-Prozesse.
Fehlerbehebung während der Beweisführung
Bei der Beweisführung wurden laut Anthropic Hunderte Fehler entdeckt. Die Forschenden richteten den Ablauf so ein, dass Claude nicht bei jedem Fund auf einen Menschen warten musste: Das Modell konnte den Code korrigieren, aus der überarbeiteten Version erneut eine Spezifikation erzeugen lassen und anschließend die Beweisführung fortsetzen.
Als konkretes Beispiel beschreibt das Unternehmen einen Zählerunterlauf in einer Kopie eines Dekompressors. Er führte zu einem Schreibzugriff außerhalb des vorgesehenen Speicherbereichs, trat aber nur bei etwa 20 MB großen Eingaben mit einer bestimmten, seltenen Struktur auf. Gewöhnliches Fuzzing würde diesen Fall den Autoren zufolge nur schwer entdecken, weil es meist kleine Eingaben verändert, deren Größe üblicherweise auf 1 MB begrenzt ist.
Funktionale Eigenschaften als Teil der Beweise
Der Nachweis der Absturzfreiheit kann laut Anthropic auch eine funktionale Eigenschaft beweisen, wenn der Test sie mit einer Assertion, also einer Prüfbedingung, kontrolliert. Beim Kompressionsalgorithmus LZO verlangt ein Test beispielsweise, dass Komprimieren und anschließendes Dekomprimieren wieder die ursprüngliche Eingabe ergeben. Eine Verletzung dieser Bedingung löst einen Absturz aus; der Beweis der Absturzfreiheit umfasst deshalb auch diese Eigenschaft.
Bei der Überprüfung von cpp-httplib musste Claude laut dem Unternehmen außerdem einen möglichen Stacküberlauf durch Rekursion im Destruktor von std::set ausschließen. Die Rekursionstiefe hängt von der maximalen Tiefe eines Baums ab. Dafür war ein Beweis direkt auf Maschinencode-Ebene nötig, dass der Algorithmus zum Ausbalancieren des Rot-Schwarz-Baums in libc++ dessen Tiefe logarithmisch begrenzt hält.
Umgebung und Testumfang bestimmen die Gültigkeit
Anthropic bezieht die Beweise auf sämtliche modellierten Antworten von Linux und alle modellierten Speicherlayouts. Voraussetzung ist jedoch ein statisch gelinktes Programm mit einem einzigen Thread und festem Speicherbudget auf einem RISC-V-Prozessor. Die überprüften Binärdateien verwenden musl libc; im üblichen Einsatz laufen diese Bibliotheken dagegen auch auf x86- oder ARM-Prozessoren und werden dynamisch mit glibc gelinkt.
Das Unternehmen grenzt auch den Prüfumfang innerhalb der Bibliotheken ein: Es hat nicht alle Einstiegspunkte überprüft, und das Werkzeug AddressSanitizer erkennt nicht sämtliche Speichersicherheitsfehler. Selbst die Überprüfung aller Einstiegspunkte würde beispielsweise toten Code nicht zwangsläufig erfassen. Weitere Fehler können im aufrufenden Programm entstehen, wenn es die Bibliothek falsch verwendet.
Die Beweise selbst werden laut Anthropic von Rocq geprüft und benötigen daher praktisch keine manuelle Durchsicht. Entwickler müssen allerdings weiterhin den formalen Modellen des Prozessors und der Linux-Prozesse vertrauen. Ebenso entscheidend sind der genaue Wortlaut der bewiesenen Aussagen und die Korrektheit des Rocq-Beweisprüfers.
Anthropics Tests: Weniger Token durch Opus 5.5 und Beweiswiederverwendung
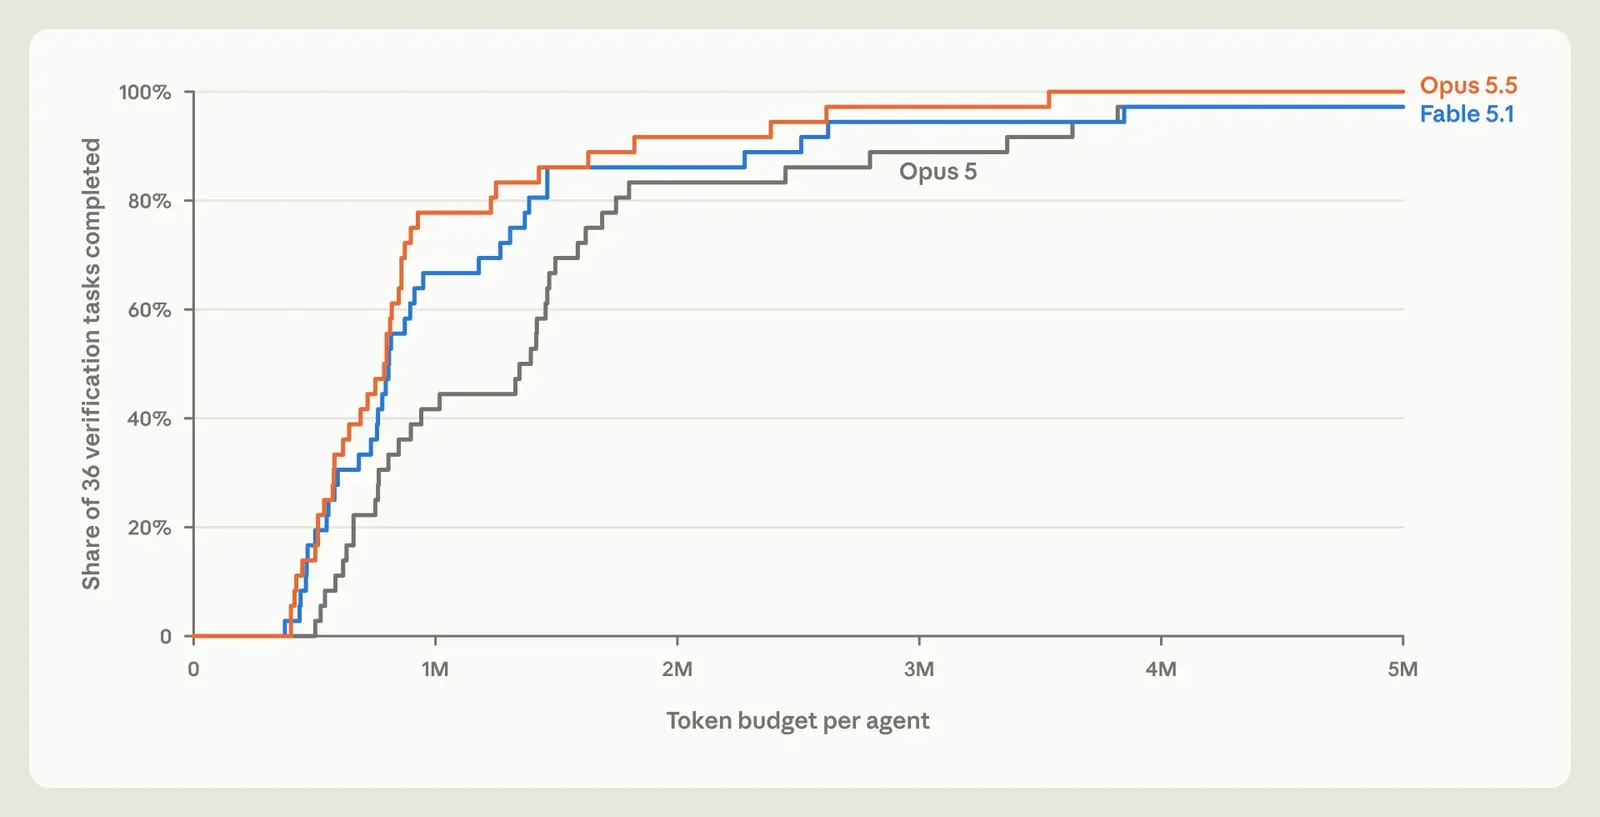
Anthropic stellte aus OSS-Fuzz-Code außerdem 36 kleine Verifikationsaufgaben für einen Modellvergleich zusammen. In diesem Test bewies Opus 5.5 laut dem Unternehmen die Hälfte der Aufgaben mit rund 40 % weniger Token als Opus 5.
In einem weiteren Experiment konnten Agenten über einen gemeinsamen Arbeitsbereich die Beweise anderer Agenten übernehmen. Gegenüber der Einzelarbeit verbrauchten sie laut Anthropic 17 % weniger Token. Einige Agenten lösten zudem Aufgaben, an denen sie zuvor bei einem eigenständigen Versuch gescheitert waren.
Veröffentlichte Beweise und Zugang für weitere Projekte
Anthropic veröffentlicht die für das Projekt entwickelten, bislang nicht öffentlichen Komponenten, auf deren Korrektheit die Verifikation angewiesen ist. Hinzu kommen die vollständigen Rocq-Beweise für Tests, die keine Korrekturen erforderten, sowie Spezifikationen einiger Tests, deren Beweis nicht gelang. Beweise, die einen noch nicht behobenen Fehler in Open-Source-Software offenlegen könnten, hält das Unternehmen zurück.
Theorem bietet das gleiche Verifikationsverfahren auch weiteren Open-Source-Projekten an. Zugleich veröffentlicht das Unternehmen einen Claude-Skill, der Entwicklern den Einstieg in die Verifikation ihres eigenen Codes erleichtern soll.