Sakana AI a spolupracovníci z UC Berkeley zveřejnili výzkumnou metodu MASS, která propojuje řízení týmu agentů s dotrénováním jediného jazykového modelu. Stejný model práci vykonává, hodnotí a upravuje její organizaci. Podle výzkumníků dva cykly zlepšily model s otevřenými váhami a 27 miliardami parametrů na výzkumných úlohách bez jednoznačné správné odpovědi, bez externích anotací či silnějšího učitele během tréninku.
Jeden model, oddělené role a přesný plán
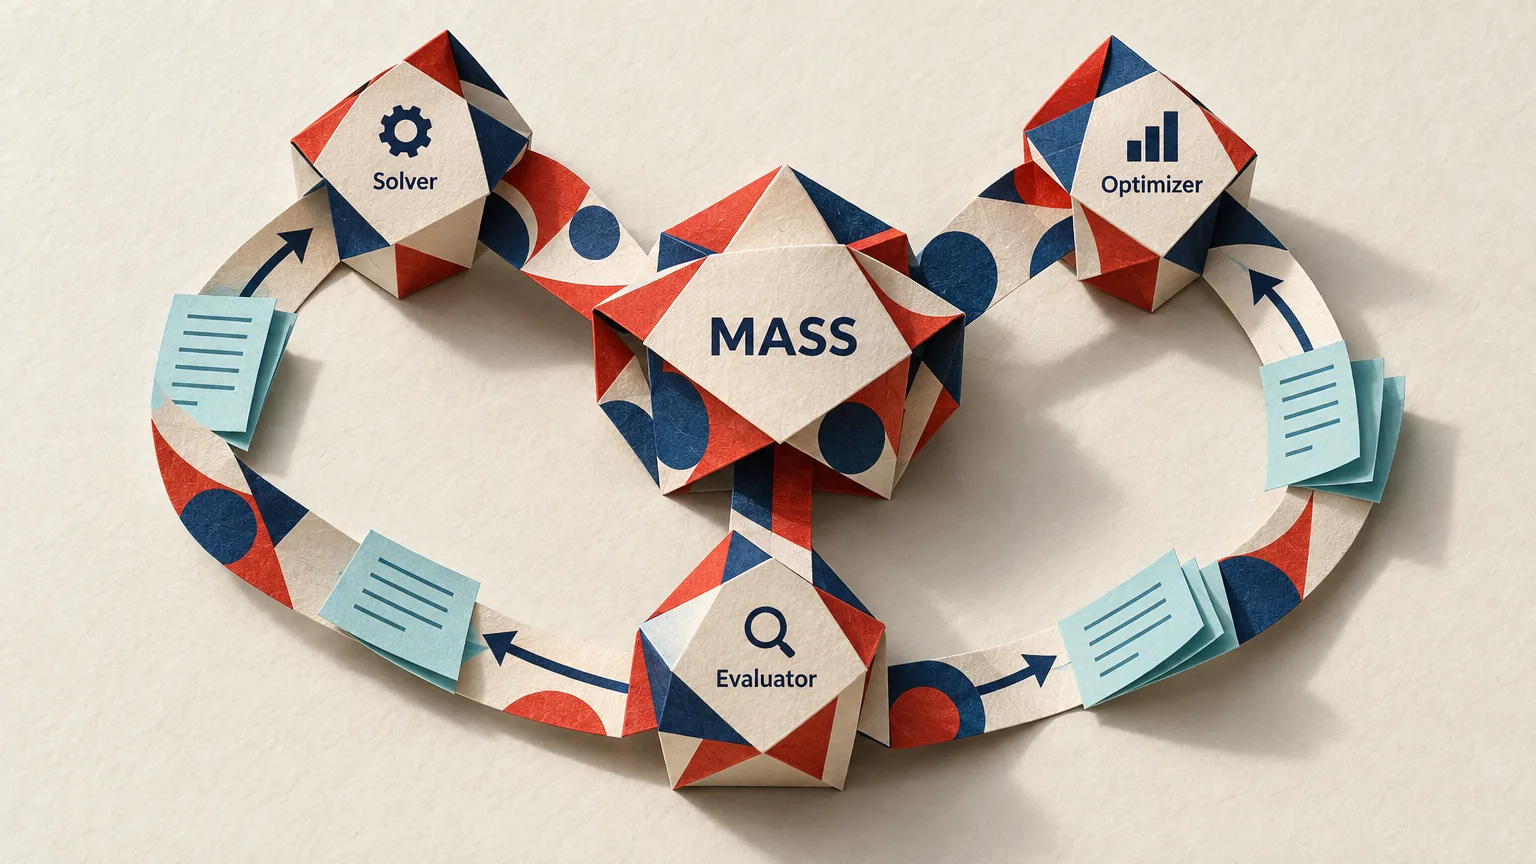
MASS znamená Multi-Agent Self-Supervision. V návrhu Sakana AI a UC Berkeley nejde o tým různých modelů: jednotlivé role zastávají samostatná volání téhož modelu. Řešitelský tým zpracovává úlohu, optimalizátor mění pracovní postup a hodnotitel porovnává dokončenou práci.
Spolupráci řídí písemný plán. Ten každému subagentovi přiděluje odpovědnost a instrukce, ale také určuje, jaké výstupy, důkazy a kontroly musí odevzdat. Další část stanovuje pořadí volání a předávání práce mezi agenty.
Výzkumníci pozorovali, že úspěšné postupy během hledání zpřesňovaly právě požadavky na výstupy, kontroly a závislosti mezi agenty. Ve finanční úloze například datový specialista musel dodat explicitní kontroly úniku dat, než k nim získali přístup navazující agenti.
Nejprve hledání postupu, potom změna vah
Tréninkový proces podle autorů střídá dvě smyčky. Ve vnitřní se váhy modelu nemění a systém pro každou úlohu uchovává dosud nejlepší pracovní postup. Nového kandidáta spustí, shromáždí jeho zprávy a výstupy a nechá hodnotitele porovnat je s dosavadním nejlepším výsledkem. Toto porovnání dostane optimalizátor jako podklad pro další úpravu.
Ve vnější smyčce se nejlepší postup spouští 18krát pro každou úlohu. Aktuální model porovnává výsledky po dvojicích a Bradleyho–Terryho model z těchto porovnání odvozuje relativní skóre. Až 16 vybraných průběhů na úlohu pak slouží k dotrénování konverzací orchestrátoru a subagentů metodou LoRA.
Před dotrénováním výzkumníci odstraní písemný plán z promptu orchestrátoru. Model se podle jejich návrhu učí koordinační rozhodnutí zachycená v úspěšných konverzacích, místo aby přímo kopíroval text plánu.
Výsledky ve výzkumných a softwarových úlohách
Sakana AI a UC Berkeley experimentovaly s Qwen3.6-27B v prostředí kódovacího agenta qwen-code. Trénink tvořilo 12 syntetických výzkumných úloh z financí, robotiky a farmacie; další tři syntetické úlohy zůstaly vyhrazené pro testování. Autoři uvádějí růst podílu vítězství nad základním modelem v párovém hodnocení z 53,9 % po prvním cyklu na 69,9 % po druhém, přičemž druhý výsledek se vztahuje k vyhrazeným testovacím úlohám.
Na MLR-Bench, DSBench, ScienceAgentBench a AstaBench dosáhl MASS podle výzkumníků po dvou cyklech 1,2–1,6násobku skóre základního modelu na výstupní token. Tato metrika vztahuje výkon k množství vygenerovaného textu; základní model má hodnotu 1,0.
V softwarových benchmarcích však stejné hodnocení ukázalo regresi. Autoři naměřili v Terminal-Bench 2.0 jen 0,96násobek a v SWE-bench Verified 0,94násobek skóre základního modelu na výstupní token. Tréninková sada neobsahovala úlohy softwarového inženýrství.
Co ukázalo srovnání s jediným agentem
V dalším porovnání dosáhl model trénovaný metodou MASS podle Sakana AI a UC Berkeley 68,3% podílu vítězství po zpracování 28,8 milionu tréninkových tokenů. Nejlepší varianta trénovaná na práci jediného agenta dosáhla 64,0 % při 42 milionech tokenů.
Přestože trénink využíval pouze průběhy řešení úloh, výzkumníci zaznamenali zlepšení také v rolích optimalizátoru a hodnotitele. Shoda interního hodnotitele s externími posuzovateli vzrostla napříč cykly ze 73 % na 93 %.
Samostatný ablační experiment ponechal základní model jako řešitele, ale optimalizaci i hodnocení svěřil GPT-5.5. V této konfiguraci podle autorů vznikly vítězné postupy pro všech 12 úloh během pěti iterací. Posílení pouze hodnotitele přineslo menší zlepšení.
Open-source implementace a limity společných vah
Autoři upozorňují, že oddělené role neodstraňují provázanost chyb, protože subagenti sdílejí váhy. Mylný předpoklad může projít řešením, hodnocením i optimalizací jako zdánlivý pokrok. Ani hledání pracovního postupu nemusí již nalezený kvalitní plán soustavně zlepšovat.
Vedle článku je dostupná open-source implementace MASS. Pro externí hodnocení výzkumníci použili GPT-5.5 a Claude Opus 4.8, jejichž posudky nebyly během tréninku metodě dostupné. Reprodukce tohoto hodnocení vyžaduje přístup k oběma modelům.