Tencent vydal váhy Hy4, nového modelu rodiny Hunyuan. Přijímá text, obrázky i video a podporuje kontext až 1 048 576 tokenů, v němž může tyto vstupy zpracovávat společně. Model má celkem 770 miliard parametrů, při zpracování každého tokenu jich aktivuje 49 miliard.
Jak Hy4 zpracovává obraz a dlouhý kontext
Obrazovou část zajišťuje transformátor s 1,23 miliardy parametrů. Obrázky a snímky videa s proměnlivým rozlišením převádí na tokeny, které následně vstupují do stejné soustavy vrstev jako text.
Pro dlouhý kontext Hy4 využívá Gated DeepSeek Sparse Attention a IndexCache. Výběrový mechanismus pro každý token vybírá 2 048 pozic, které považuje za nejdůležitější, a mezipaměť umožňuje tento výběr znovu použít v dalších vrstvách.
Součástí modelu je také dekodér DFly2, který navrhuje tokeny předem. Jeho návrhové vrstvy sdílejí s odpovídajícími vrstvami Hy4 KV cache i vybrané pozice. Podle Tencentu dekodér nepotřebuje další paměť pro KV cache; skutečné zrychlení závisí mimo jiné na tom, kolik navržených tokenů model přijme, a na podpoře použitého frameworku.
Co ukazují srovnání s Hy3 a DeepSeekem
V testu SimpleQA zaměřeném na faktické znalosti dosáhl Hy4 v publikovaném srovnání Tencentu skóre 57,2, zatímco Hy3 preview získal 26,4. V generování kódu podle testu MBPP-plus byl naopak úspěšnější DeepSeek-V4-Pro-Base se skóre 79,1 proti 74,0 u Hy4.
Tencent v interních hodnoceních uvádí pokles míry halucinací z 15,76 % u Hy4 preview na 5,45 %. U kategorie, kterou firma interně označuje jako spekulativní chyby, zaznamenal pokles z 23,1 % na 5,6 %.
Firma zároveň uvádí, že Hy4 zaostává za uzavřenými modely ve výzkumné matematice, dlouhodobém programování, sebezdokonalování modelů a pokročilém odpovídání na otázky o obrazu.
Finance, výzkum a vývoj her
Tencent hodnotil model také na 579 finančních úlohách za účasti 213 finančních profesionálů. Hy4 podle firmy získal průměrné skóre 3,04 a mezi testovanými modely s otevřenými vahami skončil před DeepSeek-V4.1-Flash, Kimi K3.1 Pro a GLM-5.3.
Při tréninku s vývojáři Tencent IEG se tým zaměřil na práci s Unreal Engine, Unity a Godot. Tencent oproti preview verzi uvádí zlepšení o 19,1 % v GameDev a o 9,8 % v GameLogic.
V interním benchmarku TenureTrail, který obsahuje 123 výzkumných úloh ze sedmi oborů, se Hy4 podle Tencentu umístil první mezi modely s otevřenými vahami, které firma testovala.
Váhy, paměť a možnosti nasazení
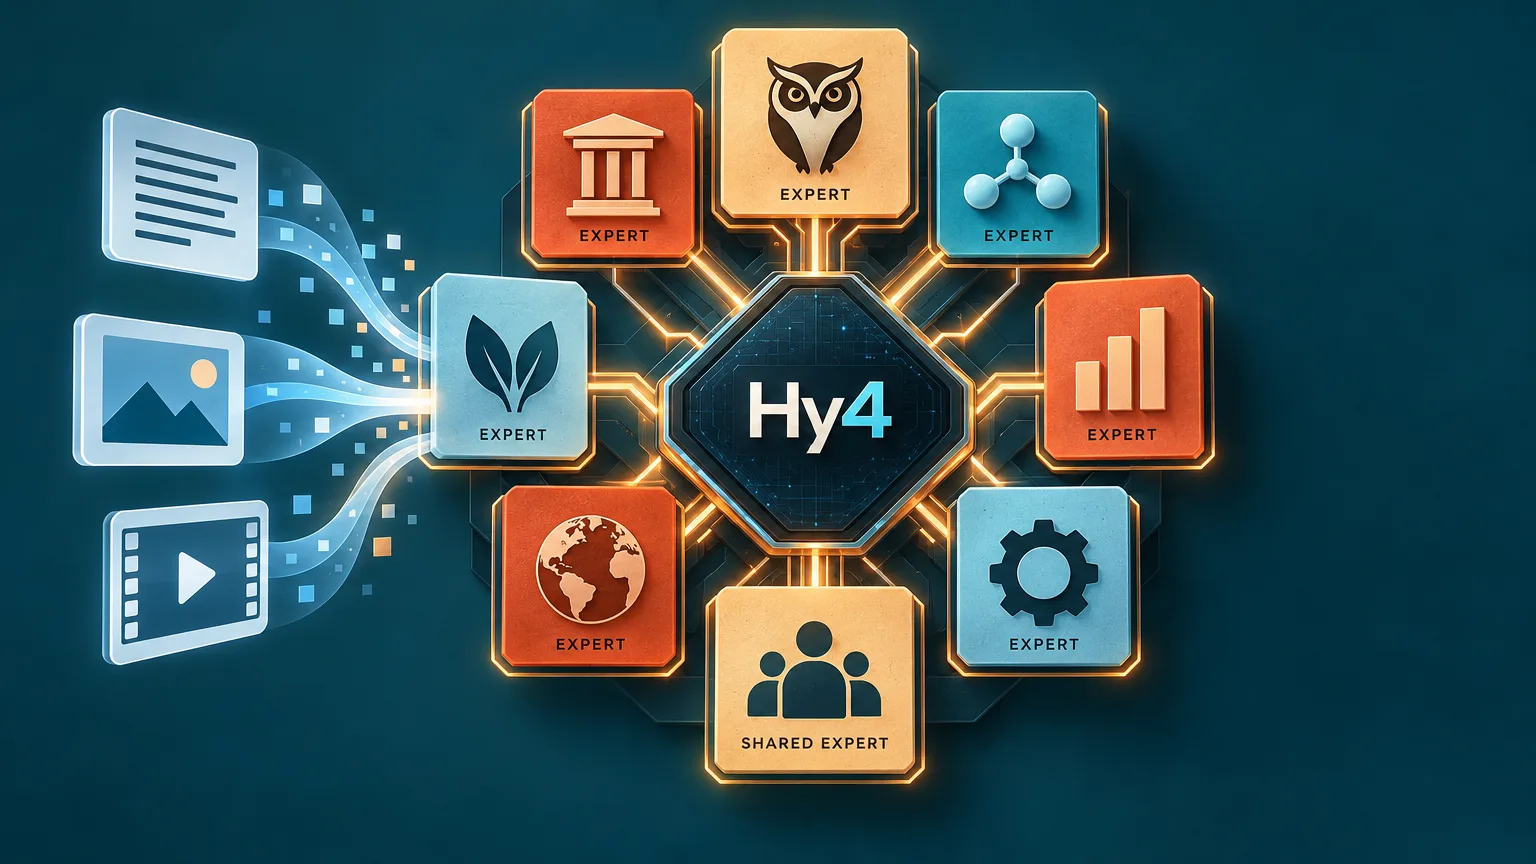
Jazyková část používá architekturu mixture-of-experts se 78 vrstvami. V každé vrstvě tohoto typu je 256 směrovaných expertů a jeden sdílený; pro jednotlivý token se aktivuje osm směrovaných a sdílený expert.
Oficiální úložiště nabízí soubory s vahami ve formátech BF16 a FP8. Pro kvantizované nasazení a experimenty je dostupné také komunitní sestavení GGUF. Samotné váhy zabírají přibližně 1,54 TB v BF16 nebo 770 GB v FP8, ještě před provozní režií.
Tencent oficiálně podporuje nasazení přes vLLM a SGLang a poskytuje připravené obrazy Dockeru. Podle firmy může model ve formátu FP8 běžet na osmi GPU s tensorovým paralelismem nastaveným na osm, pokud mají dostatek souhrnné paměti, podporují FP8 a jsou dostupná potřebná jádra pro řídkou pozornost.
Server nabízí API kompatibilní s OpenAI. Parametr reasoning_effort přepíná mezi přímými odpověďmi pomocí hodnoty „no_think“ a rozšířeným uvažováním pomocí „high“. Nativní volání nástrojů vyžaduje zapnutí příslušných parserů hy_v4.
Hy4 používá vlastní Tencent Hy License, nikoli standardní licenci schválenou OSI. Komerční nasazení se řídí omezeními a povinnostmi této licence.