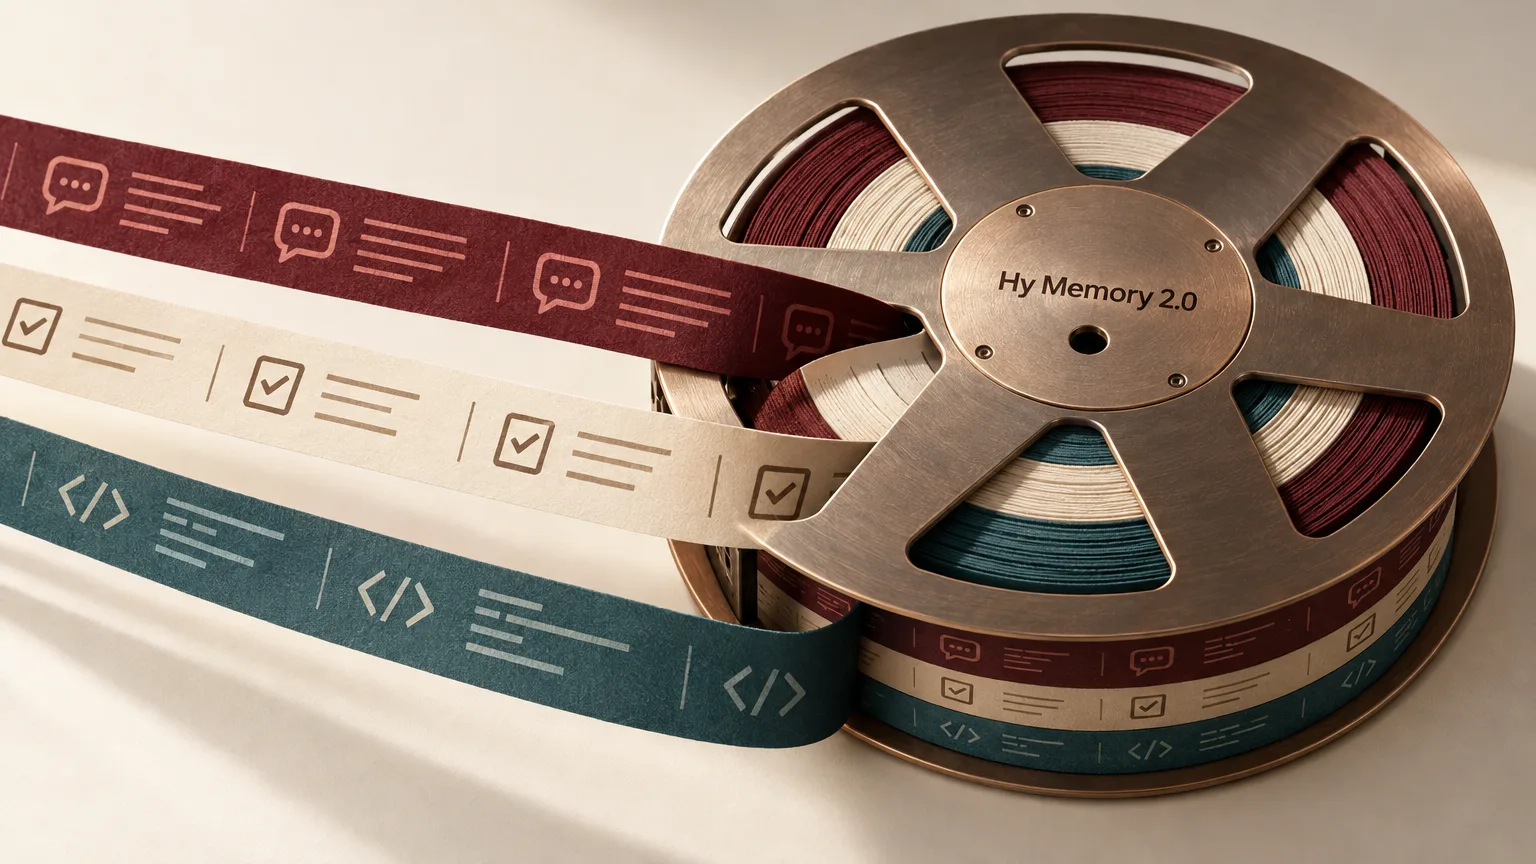
Tencent Hunyuan vydal Hy Memory 2.0, sadu pro AI agenty, která uchovává užitečný kontext mezi relacemi, nástroji a kódovými základnami. Spojuje open-source framework v Pythonu, lokální aplikaci MemHub a specializovaný model rozhodující, co uložit do dlouhodobé paměti a jak záznamy později aktualizovat.
MemHub sdílí historii mezi programovacími asistenty
MemHub je dostupný jako desktopová aplikace i nástroj pro příkazovou řádku. S povolením uživatele shromažďuje historii a záznamy práce z Claude Code a Cursoru; podporuje také Codex, OpenCode a Qwen Code. Tyto podklady ukládá do spravovaného lokálního adresáře a zpřístupňuje je přes společné běhové prostředí.
Podporovaní asistenti tak mohou využívat společnou lokální paměťovou vrstvu. Při nasazení je potřeba nastavit oprávnění jednotlivých aplikací a přístup k adresáři s importovanými daty.
Chat, pracovní zkušenosti a přesné revize kódu
Framework rozlišuje tři způsoby zpracování paměti. Pipeline Chat má osm hierarchických vrstev L0 až L7. Vedle základních informací uchovává původní dialog a jednotlivá fakta, ale také souhrny, schémata a budoucí záměry. Jakmile záměru vyprší platnost, převede jej na běžné faktum.
Pipeline Working zaznamenává jedno faktum za pracovní relaci. Samostatně ukládá opakovaně využitelné zkušenosti, pokud překročí stanovený práh hodnoty; obě vrstvy přitom vzájemně propojuje.
Pro programování přidává pipeline Coding k pracovní paměti verzovaný řetězec změn. Vektorové vyhledávání nejprve vybere relevantní fakta a následně se k nim připojí všechny revize dotčeného kódu. Zdrojem jsou lokální Git diffy nebo deterministické náhrady zaznamenané při použití nástrojů, takže paměť zachovává i přesné úpravy, které může pouhý souhrn vynechat.
Jedno vlákno historie sleduje jeden blok jedné funkce v konkrétním souboru a na konkrétní větvi. Vlákna jsou oddělena podle uživatele a pracovního prostoru, aby se v témže řetězci nespojovaly revize z nesouvisejících repozitářů nebo různých identit.
Specializovaný model lze zapojit i do Mem0 a MemOS
Zápis paměti zajišťuje Hy-Memory-30B-A3B. Jde o model s architekturou MoE, který má 30 miliard parametrů, z nichž jsou aktivní přibližně tři miliardy. Jeho úkolem je vybrat informace k uchování, určit přesnost jejich zápisu a podle pozdějších podkladů upravovat trvalou paměť.
Model není omezený na nový framework. V systémech Mem0, MemOS nebo Hy-Memory může převzít roli obecného jazykového modelu zapisujícího paměť, aniž by tým měnil okolní systém vyhledávání.
Tencent porovnal zápis paměti s Claude Opus 5
Tencent uvádí pro Hy-Memory-30B-A3B makroprůměrné skóre 55.49 napříč čtyřmi testovacími prostředími. Ve stejném hodnocení dosáhl Claude Opus 5 skóre 54.62 a DeepSeek V4.1 Flash 53.64. Základní model Qwen3-30B-A3B získal 44.37.
V hodnocení Tencentu se měnil pouze model zapisující paměť. Verze testovacích prostředí i prompty zůstaly stejné; neměnilo se ani nastavení vyhledávání, modely vytvářející odpovědi, hodnotitelé nebo testovací příklady. Každý zapisující model začínal s prázdnou pamětí a budoval vlastní stav.
Makroprůměr zahrnoval šest metrik: LoCoMo Judge a LongMemEval, dále PersonaMem-v2, Travel SPS, Shopping PS a Code Memory Bench. Výsledky tedy popisují účinek zapisovacího modelu v pevných sestavách, nikoli porovnání kompletních agentních systémů s různým vyhledáváním či nástroji.
Trénink sleduje vývoj paměti po částech
Tencent při tréninku používá Memory On-Policy Distillation. Zmrazený učitelský model při ní poskytuje podrobný dohled nad řetězci paměťových stavů, které vytváří trénovaný model.
Ve fázi Attributed Memory Reinforcement Learning Tencent hodnotí dokončené paměťové banky a přiřazuje zásluhu jednotlivým blokům vstupu. Skóre normalizuje mezi průběhy na stejné pozici bloku. Banka s nejvyšším součtem dílčích skóre pak slouží jako výchozí stav pro následující kontextové okno.
Pro prostředí EverMemOS, které Tencent vynechal z tréninku, firma uvádí skóre 56.89. Interpretuje je jako doklad, že naučený způsob zápisu paměti lze přenést i mimo tréninková prostředí.
SDK je na PyPI a nabízí tři provozní režimy
SDK je dostupné na PyPI jako hy-memory==2.0.1 pod licencí Apache-2.0. Vyžaduje endpoint jazykového modelu kompatibilní s OpenAI a endpoint pro embeddingy. Volitelně lze připojit Qdrant či FAISS, využít Neo4j nebo MySQL a doplnit lokální vícejazyčný model pro přerovnávání výsledků.
Režim lite ukládá původní obsah pro vektorové vyhledávání bez volání jazykového modelu. Režim pro přidává modelovou extrakci a slučování paměti. Varianta ultra navíc odvozuje abstraktnější schémata a přes evolve() spouští mechanismus pro úpravu paměti napříč doménami.
Samotný Hy-Memory-30B-A3B lze provozovat přes vLLM nebo SGLang za standardním API kompatibilním s OpenAI. Pro přímou extrakci faktů bez rozšířeného uvažování mohou požadavky použít nastavení reasoning_effort: no_think.