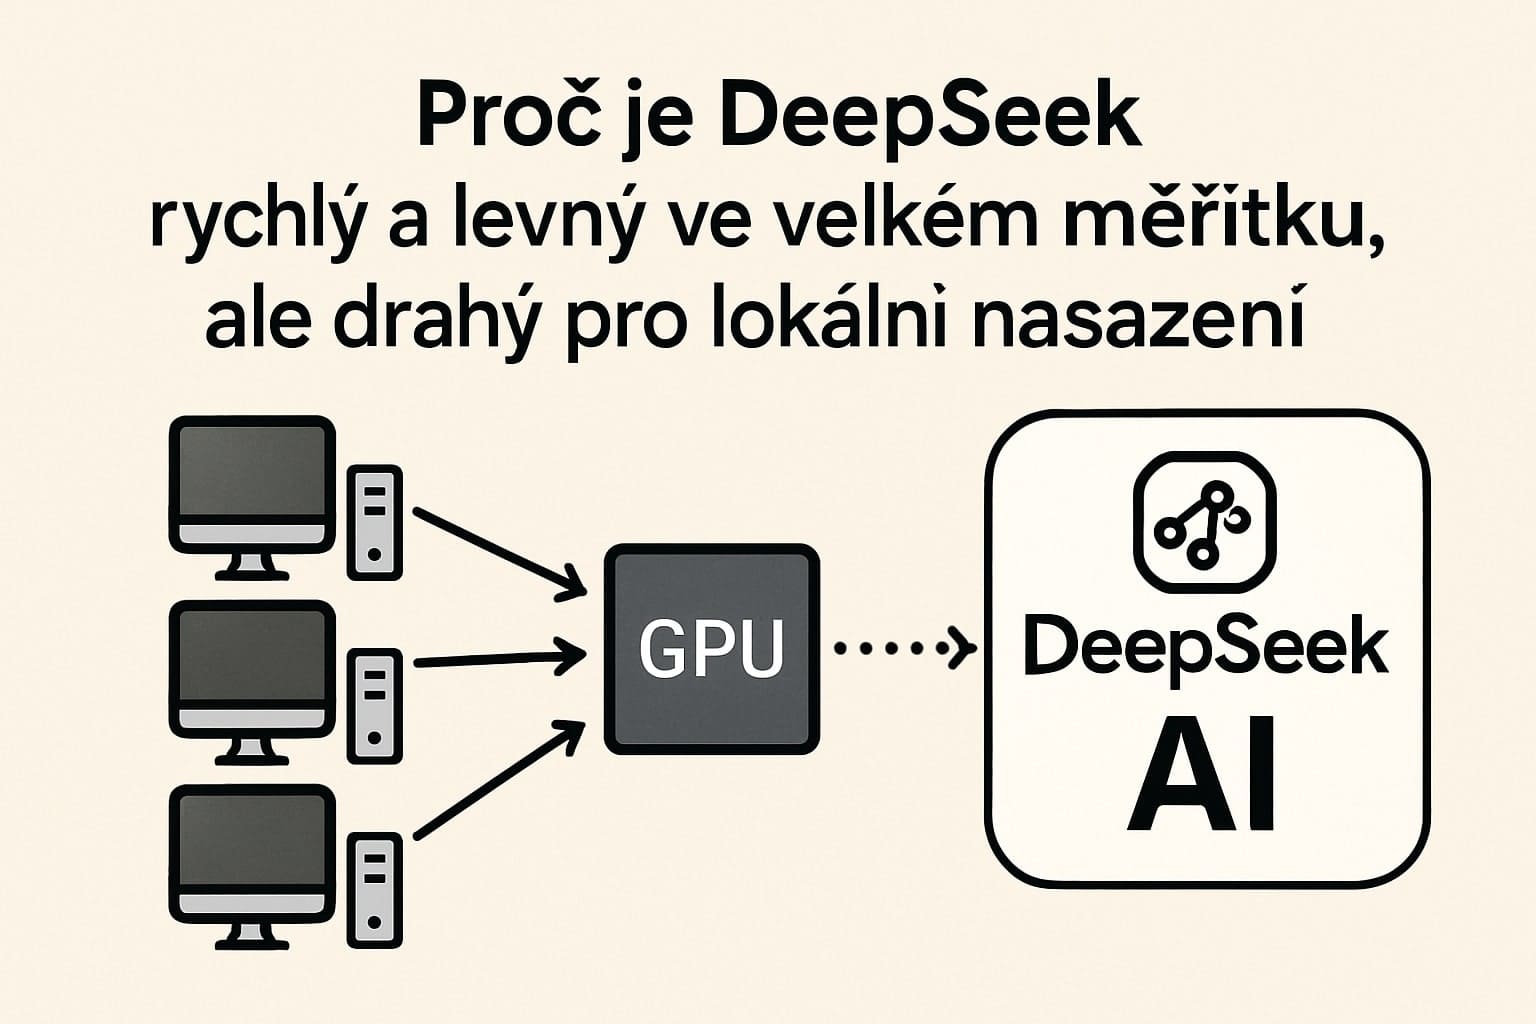
Proč je DeepSeek rychlý a levný ve velkém měřítku, ale drahý pro lokální nasazení
Pokud jste si někdy kladli otázku, proč jsou modely DeepSeek proslulé svou rychlostí a nákladovou efektivitou ve velkých cloudových nasazeních, ale současně se jeví jako pomalé a drahé při lokálním použití, máte se dozvědět fascinující příběh o inferenčním dávkování transformerů.
Základy: Průchodnost versus latence
Celé téma začíná u fundamentálního kompromisu v oblasti strojového učení - volby mezi průchodností a latencí. Průchodnost představuje schopnost systému zpracovat velké množství požadavků současně, zatímco latence měří rychlost odpovědi na jednotlivý požadavek. Poskytovatelé služeb se často ocitají před dilematem: zvolit vysokou průchodnost pro mnoho uživatelů s pomalejšími individuálními odpověďmi, nebo nízkou latenci pro rychlé odpovědi jednotlivcům s neefektivním využitím pro mnoho uživatelů. Modely jako DeepSeek-V3 jsou v malém měřítku natolik neefektivní z hlediska využití GPU, že vyžadují dávkování mnoha uživatelských požadavků současně, aby dosáhly rozumné průchodnosti. Tato charakteristika není náhodná - je to důsledek architektury transformerů a způsobu, jakým tyto modely zpracovávají informace.
Síla dávkování skrze uživatele
Klíčem k efektivitě DeepSeeku je dávkování inference napříč více uživatelskými požadavky namísto zpracování každého požadavku jednotlivě. Transformery jsou navrženy tak, že generování dokončení pro dávku vstupů je téměř stejně rychlé jako generování pro jediný vstup, pokud je dávka konstruována efektivně. Co to znamená v praxi? Představte si situaci, kdy máte tisíce uživatelů současně posílajících dotazy na váš model. Místo zpracování každého dotazu izolovaně můžete tyto dotazy seskupit do dávek a zpracovat je paralelně. Transformer architektura umožňuje, aby se zpracování operace a další výpočty prováděly současně pro celou dávku, což dramaticky zvyšuje efektivitu. Efektivní dávkování ale vyžaduje, aby sekvence v dávce měly podobné délky, takže generování tokenů může být synchronizováno. Ve velkém měřítku, kdy spousta uživatelů posílá požadavky, může DeepSeek zpracovávat mnoho z nich paralelně, maximalizuje využití GPU a minimalizuje náklady na jeden požadavek.
Překážky a omezení dávkování
Dávkování však není všelék. Je efektivní pouze tehdy, když jsou zpracovávané sekvence ve stejné fázi - například všechny generují stejnou pozici tokenu. Rozdíly mezi sekvencemi vyžadují samostatné operace pozornosti a narušují efektivitu dávkování. Moderní inference stacky používají "kontinuální dávkování", kde se nové požadavky přidávají do dávky, jakmile je volná kapacita. Fundamentální kompromis mezi průchodností a latencí však zůstává. Lokálně málokdy máte dostatek současných požadavků pro vytvoření velkých, efektivních dávek, což vede k špatnému využití GPU, pomalejším odpověďím a vyšším nákladům na požadavek. Pro skutečně rozsáhlé případy použití využívá distribuovaná dávková inference rozložení dávek napříč více GPU uzly. Právě takto dosahují cloudoví poskytovatelé měřítka a úspor nákladů s modely jako DeepSeek. Když máte k dispozici stovky nebo tisíce GPU rozdělené do clusterů, můžete vytvořit obrovské dávky a dosáhnout neuvěřitelné efektivity.
Pro jednotlivého uživatele nebo malý tým provozující DeepSeek lokálně však těchto měřítek nelze dosáhnout, a proto ztrácíte tyto výhody efektivity. Váš jediný dotaz nebo několik současných dotazů jednoduše nevytvoří dostatečně velkou dávku pro efektivní využití výpočetní síly modelu.
Klíčové pozorování
DeepSeek modely jsou architektonicky navrženy pro poskytování efektivity prostřednictvím velko-dávkové, vysoko-průchodné inference. Toto je dosažitelné pouze ve velkém měřítku, kde lze mnoho uživatelských požadavků seskupit dohromady. Provozování DeepSeeku lokálně nebo pro individuální požadavky vede k malým velikostem dávek, špatnému využití GPU a mnohem vyšším nákladům na požadavek, což jej činí nepraktickým pro ne-škálované scénáře.
Tento fenomén vysvětluje, proč vidíme takový kontrast mezi zkušenostmi uživatelů cloudových služeb využívajících DeepSeek a těmi, kteří se pokouší o lokální nasazení. Není to chyba modelu nebo implementace - je to přirozený důsledek toho, jak jsou tyto pokročilé jazykové modely fundamentálně navrženy a optimalizovány.