Co je to dlouhá pomlčka a jak ji AI používá?
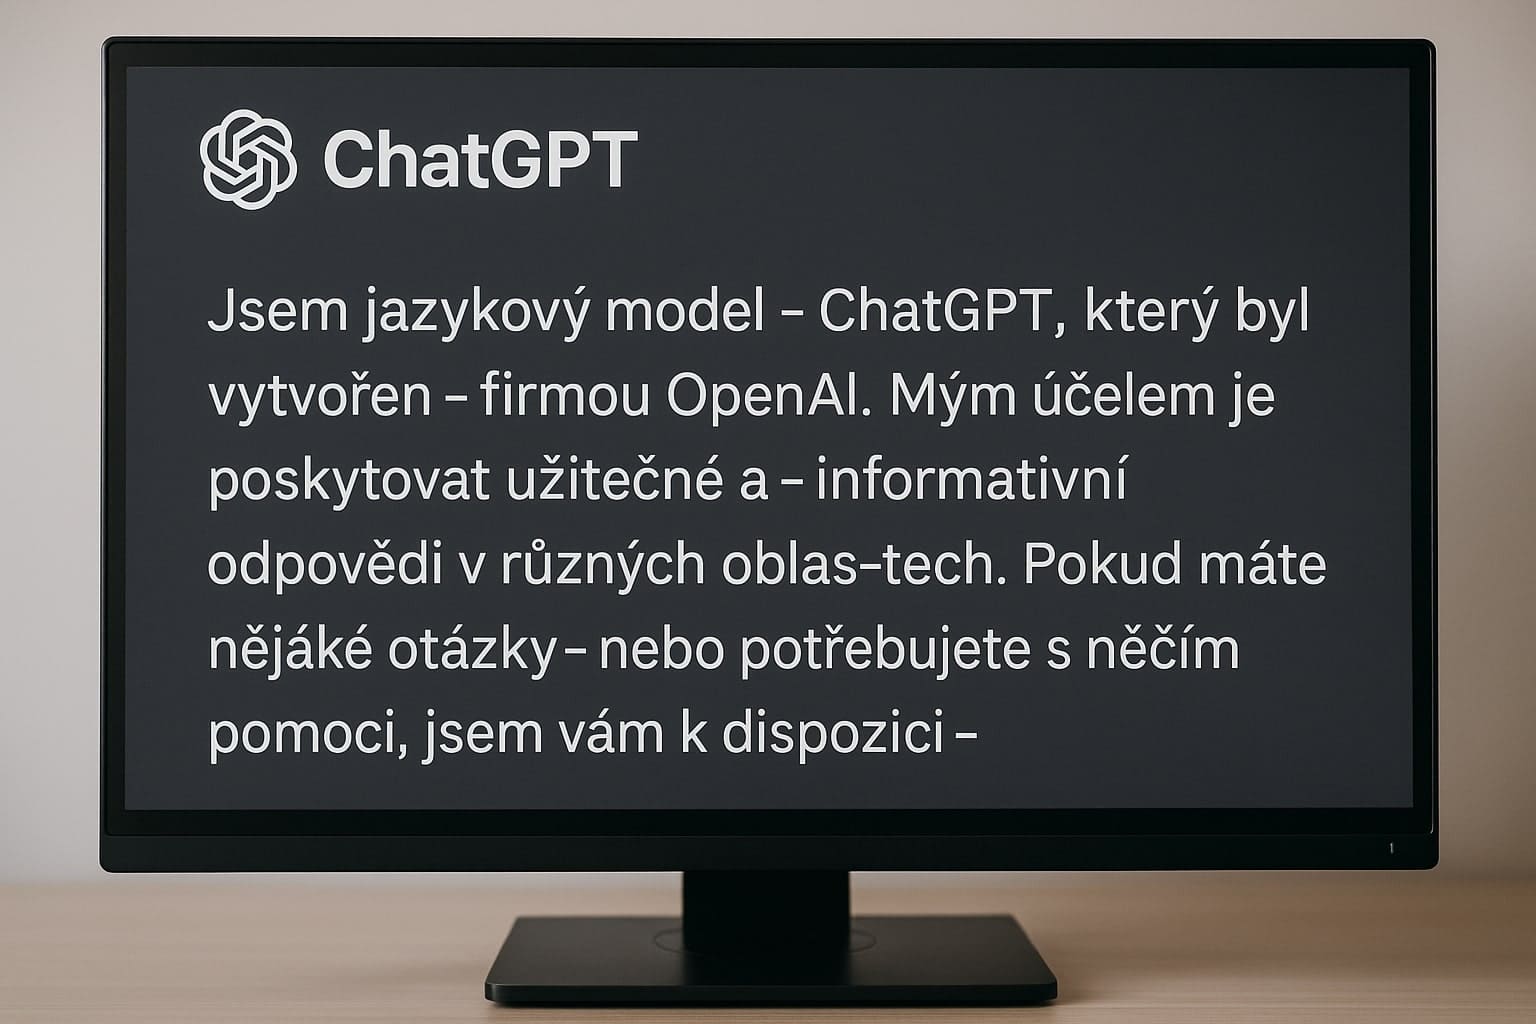
Dlouhá pomlčka, v angličtině známá jako em-dash, slouží k oddělení myšlenek v textu – například k vložení vysvětlivky nebo k vytvoření pauzy. V běžném psaní lidí se objevuje občas, ale v textech od moderních modelů umělé inteligence, jako je GPT-4o, jich bývá hodně. Sean Goedecke si všiml, že mezi lety 2022 a 2024 došlo k velké změně. Starší model GPT-3.5 používal dlouhé pomlčky podobně jako lidé v současných textech, ale novější GPT-4o je vkládá dramaticky víc. To ho přimělo pátrat po důvodech.
Goedecke porovnává data z různých modelů a zjišťuje, že tato změna souvisí s tím, jak se trénují tyto systémy. Umělá inteligence se učí z obrovského množství textů, které slouží jako tréninková data. Pokud se tato data změní, změní se i styl psaní AI.
Hlavní hypotéza: Digitalizace starých knih
Sean Goedecke navrhuje, že klíčem k celému jevu je způsob, jakým se získávají tréninková data pro novější modely. Podle jeho analýzy laboratoře OpenAI začaly mezi lety 2022 a 2024 používat více digitalizovaných tištěných knih. Tyto knihy často pocházejí z 19. století, kde bylo používání dlouhých pomlček na vrcholu. Konkrétně cituje studii, která ukazuje, že frekvence pomlček dosáhla maxima v 60. letech 19. století.
Proč zrovna staré knihy? Goedecke vysvětluje, že starší modely jako GPT-3.5 se trénovaly hlavně na současném obsahu z internetu, často na pirátských zdrojích. Novější modely ale potřebují kvalitnější data, takže laboratoře sáhnou po veřejně dostupných digitalizovaných knihách z minulosti. Tyto texty obsahují o 30 % více dlouhých pomlček než moderní psaní. Výsledek? AI se naučí tento styl a aplikuje ho ve svých výstupech.
Goedecke podotýká, že tato změna v datech není náhodná. Laboratoře hledají způsoby, jak zlepšit kvalitu, a digitalizace starších děl jim poskytuje bohatý materiál. Přesto zůstává paradox: i když AI používá tolik dlouhých pomlček, jejich celkový styl psaní se 19. století příliš nepodobá v jiných ohledech.
Alternativní vysvětlení, která Goedecke zvažuje
Goedecke se nezastavuje jen u jedné myšlenky. Zmiňuje i jiné možné důvody, ale považuje je za méně pravděpodobné. Například proces nazvaný RLHF (posilování učení z lidské zpětné vazby) by mohl upřednostňovat dlouhé pomlčky, protože dodávají textu konverzační tón. Lidé, kteří hodnotí výstupy AI, by mohli preferovat takový styl.
Další nápad souvisí s platformami jako Medium, kde se dvojité pomlčky automaticky mění na dlouhé pomlčky. Pokud by tréninková data obsahovala hodně obsahu z Medium, mohlo by to ovlivnit AI. Goedecke toto vysvětlení odmítá jako nedostatečné, protože nedokáže vysvětlit celkový nárůst v používání.
V komentářích k článku se objevují i reakce komunity. Jeden komentátor tvrdí, že za vším stojí právě chování Medium, ale Goedecke to považuje za příliš úzké vysvětlení.
Proč zůstává vysvětlení spekulativní?
Sean Goedecke je upřímný a přiznává, že jeho závěry jsou spekulativní. Bez přímých informací o tom, jak OpenAI a jiné laboratoře získávají data, nelze nic potvrdit na sto procent. Žádná jediná příčina není univerzálně přijímaná. Přesto jeho hlavní teorie – že digitalizace starších knih z 19. století způsobila nárůst dlouhých pomlček – se zdá nejsilnější.
Tento jev ovlivňuje i lidi: někteří autoři teď dlouhé pomlčky vynechávají, aby jejich texty nevypadaly jako generované AI. Goedecke to všechno popisuje s detaily, ale bez zbytečných spekulací mimo dostupná data.