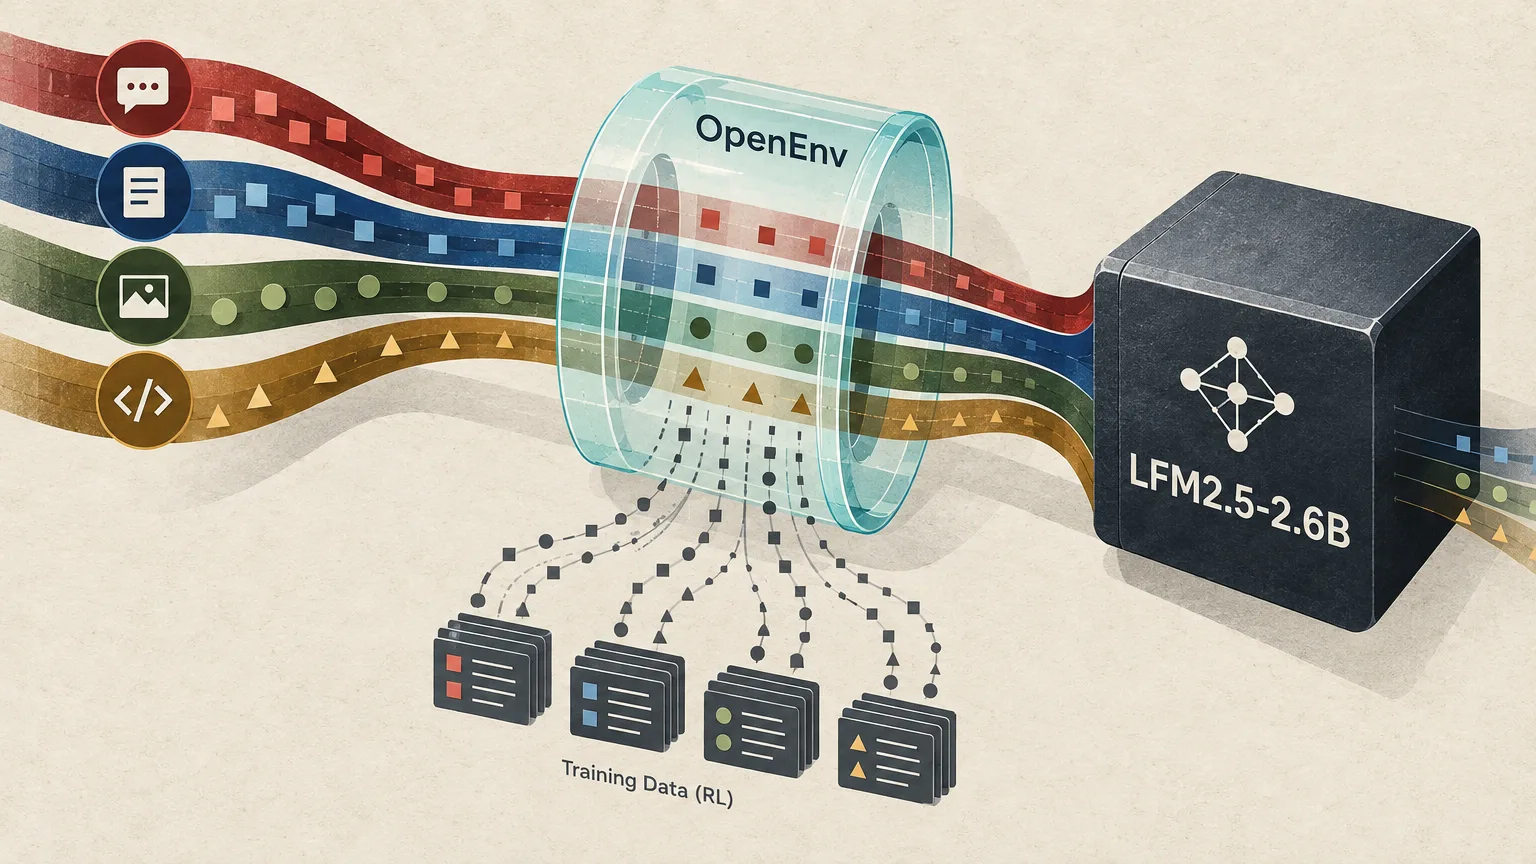
Hugging Face a Liquid AI zveřejnily otevřenou sadu nástrojů pro posilované učení modelů přímo uvnitř kódovacích agentů, včetně Claude Code, Codex a OpenCode. Vývojáři nemusí zasahovat do jejich zdrojového kódu: trénink zapojí nasměrováním požadavků na model přes proxy, která zachovává původní formát komunikace agenta a zaznamenává data potřebná pro učení.
LFM2.5-2.6B zlepšil výsledky ve čtyřech prostředích
V hlavním experimentu Hugging Face a Liquid AI vzrostla celková úspěšnost LFM2.5-2.6B z 42,2 % na 54,2 % podle metriky pass@1. Ta vyjadřuje podíl úloh vyřešených na první pokus. Zlepšení zaznamenaly oba týmy ve všech čtyřech hodnocených agentních prostředích.
Výsledky obou týmů ukázaly také menší počet volání nástrojů. Varianta trénovaná ve více prostředích jich potřebovala o 31 % méně než základní model, ale toto porovnání zahrnovalo pouze úlohy, které úspěšně vyřešily obě verze. U modelu trénovaného výhradně v OpenCode činilo snížení počtu volání 11 %.
Trénink v jediném prostředí měl podle Hugging Face a Liquid AI odlišný profil výsledků: model omezený na OpenCode dosáhl při hodnocení v OpenCode úspěšnosti 58 %. Varianta trénovaná ve více prostředích byla úspěšnější v Claude Code a Codex. Při použití v Claude Code navíc model trénovaný jen v OpenCode spotřeboval více volání nástrojů i tokenů než základní verze.
Zapojení přes adresu modelu a převod formátů API
Záchytná proxy stojí mezi agentem a inferenčním serverem vLLM. Vývojář v agentovi nastaví adresu proxy místo adresy modelu. Agent dál odesílá požadavky a přijímá odpovědi ve svém původním formátu. Proxy tak zajišťuje záznam pro trénink, aniž by bylo nutné přepracovat způsob, jakým agent komunikuje s modelem.
Proxy rozpoznává jeden ze čtyř podporovaných formátů API podle cesty požadavku, hlaviček a těla. Převodníky převzaté z NVIDIA Polar upraví vstup do formátu Chat Completions. Po vygenerování odpovědi následuje opačný převod do podoby, kterou očekává volající agent.
Tréninkový záznam zachovává tokeny i větvení
Pro aktualizace pomocí gradientu politiky nestačí archivovat pouze výsledný text. Proxy ukládá přesná ID tokenů vygenerovaných modelem a jejich zpracované logaritmické pravděpodobnosti. Pokud by se nejprve uložil text a tokenizoval až později, stejný viditelný obsah by mohl vést k jiným ID tokenů.
Další část záznamu řeší průběhy s opakovanými pokusy, podagenty nebo zkracováním kontextu. Každé volání modelu se uloží jako uzel; propojení vzniká podle nejdelšího přesného společného prefixu tokenů. Z rekonstruovaného větvení pak každá cesta od kořene k listu vytvoří jednu trénovací sekvenci.
Při vzorkování proxy používá celé rozdělení modelu: top_p má hodnotu 1,0 a omezení top_k je vypnuté. Hugging Face a Liquid AI uvádějí, že nastavení top_p na 1,0 posunulo měřený poměr importance sampling z 0,985–0,993 na 0,9984–0,9999. Hodnota blízká 1 označuje soulad pravděpodobností při generování trénovacích běhů a při samotném tréninku.
Osm pokusů o úlohu a odměna za úspornější řešení
Hugging Face a Liquid AI experimentovaly se sadou SmolDataEnvs, která obsahuje 1 000 úloh datové analýzy odvozených z notebooků Kaggle. Obě trénovací varianty používaly Async GRPO v nástroji TRL, běžely 1 000 kroků a využívaly dvě GPU H100.
Rozdíl mezi variantami spočíval ve výběru prostředí. V první probíhaly všechny pokusy v OpenCode. Ve druhé každá skupina pokusů používala jedno ze čtyř prostředí: vedle OpenCode také Claude Code, Codex nebo Mini-SWE-Agent.
V tréninku obou týmů tvořilo skupinu GRPO osm pokusů o stejnou úlohu. Správná odpověď získala odměnu 1, chybná 0. Úspěšné řešení mohlo navíc obdržet bonus až 0,1 za menší počet volání nástrojů; tento bonus poskytoval další učicí signál i ve skupinách, kde uspělo všech osm pokusů.
Samostatné srovnání s učením od většího modelu
Oba týmy vedle posilovaného učení vyzkoušely také doladění s učitelem. Model Qwen3.8-27B spustily ve všech čtyřech prostředích a z jeho běhů vybraly 3 189 úspěšných průběhů řešení. Tato data následně použily k doladění LFM2.5-2.6B.
V samostatném srovnání s učením od většího modelu dosáhlo podle Hugging Face a Liquid AI posilované učení ve více prostředích pass@1 54,6 %. Učení s učitelem pouze pro OpenCode skončilo na 47,5 %, zatímco učení s učitelem ve více prostředích na 43,1 %.
U varianty učené s učitelem ve více prostředích zaznamenaly týmy také zhoršení výsledků v Mini-SWE-Agent. Úspěšnost zde klesla z 62,1 % u základního modelu na 45,2 %, což vyrovnalo přínosy dosažené v ostatních třech prostředích.
Veřejné jsou nástroje, data i sedm checkpointů
Zveřejněná sada zahrnuje záchytnou proxy OpenEnv a skripty FineEnvs pro definování prostředí a spouštění tréninku. K dispozici je také integrace trénovacího nástroje TRL a sada úloh SmolDataEnvs. Součástí vydání jsou data pro učení s učitelem i všech sedm natrénovaných checkpointů.