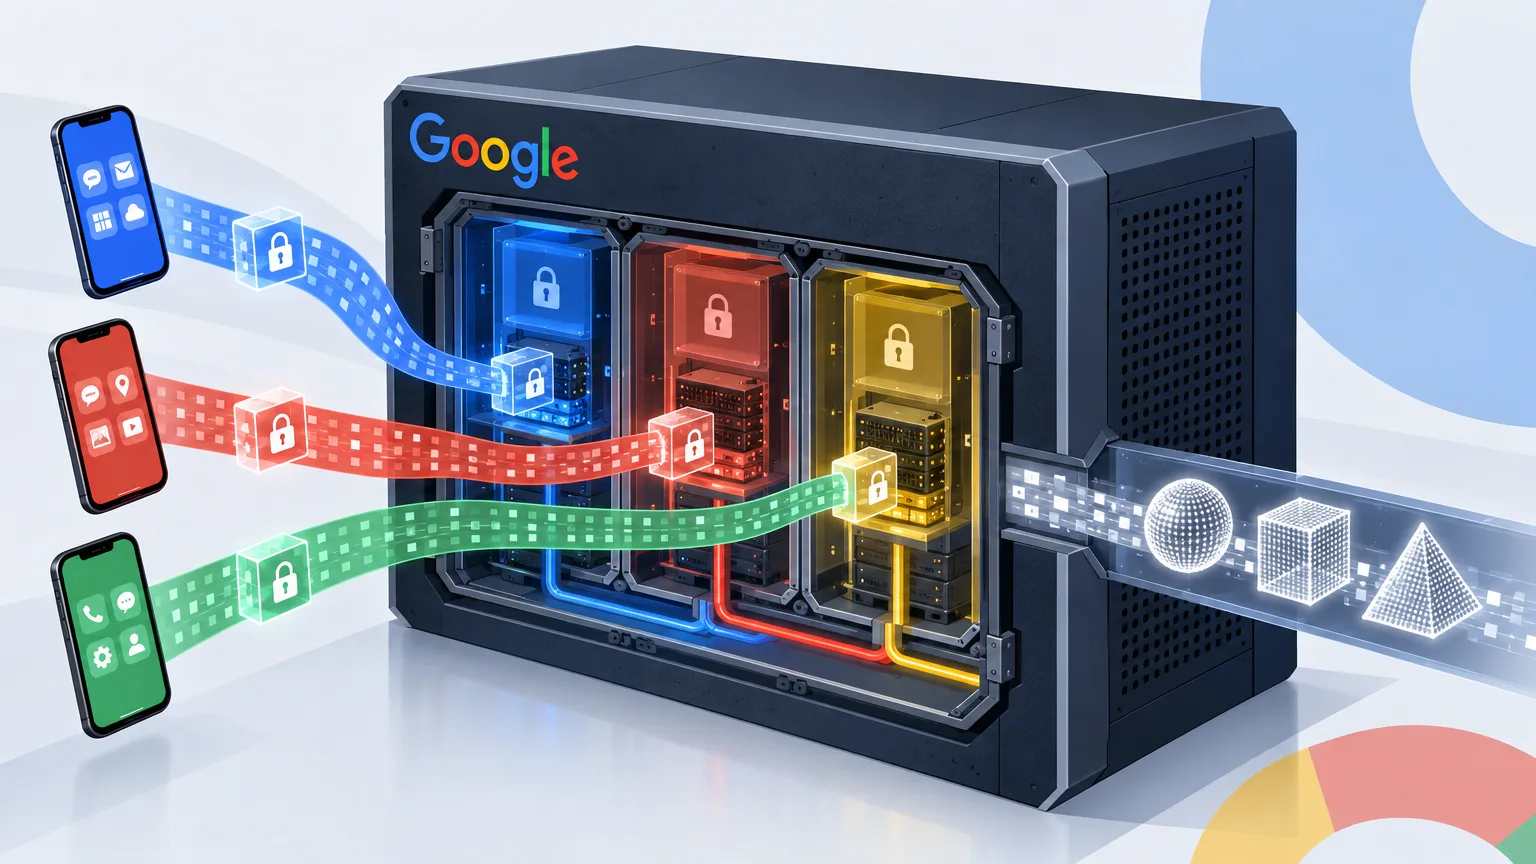
Google Research představil nový systém federovaného učení, který přesouvá výpočty ze zařízení na servery v důvěryhodných výpočetních prostředích TEE. Součástí změny je možnost externě ověřovat a auditovat anonymizaci dat. Gboard už systém nasadil pro anglické a japonské modely předpovídání dalšího slova, u nichž Google uvádí vyšší přesnost.
Trénování Gboardu méně závisí na dostupnosti zařízení
Změna se týká způsobu, jakým se modely pro klávesnici trénují. Podle Googlu dříve trénování každého z těchto modelů mohlo trvat jeden až dva měsíce. Postup omezovala dostupnost zapojených zařízení, jejich výpočetní výkon i skutečnost, že se o stejné prostředky ucházelo více trénovacích úloh.
Nový systém podle firmy trénování výrazně zrychluje tím, že rozděluje výpočty mezi mnoho serverů. Současným omezením je dostupnost prostředků TEE. Google také nejprve shromáždí všechna data nahraná zařízeními a až poté spustí serverové trénování, takže jeho průběh už neovlivňují denní výkyvy dostupnosti zařízení.
Přístup k datům určuje schválená politika
Podle popisu Googlu zařízení trénovací příklady nejprve lokálně zašifrují a následně je nahrají na server. Ještě před zpracováním schvalují přístupovou politiku: ta vymezuje konkrétní výpočty v TEE, které smějí s daty pracovat. Povolené výpočty mohou vydávat pouze anonymizované výsledky a zařízení vyžadují zveřejnění politik ve veřejném registru.
Přístup k dešifrovacím klíčům řídí systém správy klíčů KMS. Google jej popisuje jako skupinu prostředí TEE, která používá protokol RAFT pro dosažení shody. Klíče získají pouze serverové úlohy běžící v TEE, jejichž výpočty odpovídají tomu, co přístupová politika povoluje.
Python řídí paralelní výpočty i obnovu po výpadku
Samotné trénování podle Googlu vede řídicí prostředí TEE, v němž běží trénovací smyčka napsaná v Pythonu. Úkoly, které lze zpracovat souběžně, přiděluje skupině pracovních prostředí TEE. Distribuovanou logiku vyjadřuje otevřený jazyk Federated Language, odvozený od TensorFlow Federated; trénovací smyčka průběžně předává analytikovi anonymizované váhy modelu.
Pro případ selhání řídicího nebo pracovního prostředí program na konci trénovacího kola ukládá stav potřebný k obnově. Ten je zašifrovaný prostřednictvím KMS. Podle Googlu má tento postup umožnit pokračování po výpadku bez úniku dalších citlivých informací.
Auditoři mohou kontrolovat politiky i sestavení programu
Google uvádí, že provozovatelé úloh vidí pouze metriky a váhy modelů chráněné diferenciálním soukromím. Nahrané trénovací příklady lze dešifrovat a zpracovat jen uvnitř TEE s programy v Pythonu povolenými přístupovou politikou. Takové zpracování je navíc možné pouze po omezenou dobu od nahrání.
Pro externí kontrolu firma zveřejňuje přístupové politiky ve veřejném registru Rekor. Auditoři podle ní mohou sledovat všechny serverové úlohy, do nichž se zařízení mohou zapojit. Binární soubory KMS a komponent pro zpracování dat lze podle Googlu reprodukovatelně sestavit z otevřeného kódu v repozitáři Confidential Federated Compute na GitHubu.
Prostředí TEE mají podle Googlu umožňovat vzdálené ověření vykonávané logiky, chránit její vnitřní stav před pozorováním a zajistit integritu výpočtu. Podle firmy však tyto vlastnosti platí jen v mezích možností současné generace TEE.
Neveřejné části modelu lze načítat za běhu
Auditovatelnost má podle Googlu zůstat zachována i tam, kde firma nechce zveřejnit architekturu modelu nebo postup předzpracování dat. Prostředí pro zpracování proto podporují dodatečné načítání serializovaných informací do programu v Pythonu za běhu. Externě ověřitelnou ochranu soukromí Google podmiňuje tím, že veškerá logika související s ochranou soukromí zůstane pevnou součástí programu.
Lepší rozvrh účasti a cesta k větším modelům
Při serverovém zpracování může program podle Googlu dynamicky vypočítat optimální rozvrh účasti zařízení a podle něj nastavit další parametry diferenciálního soukromí. Firma porovnala nový a předchozí systém při trénování anglického modelu předpovídání dalšího slova po 5 000 kol s kohortami 6 500 zařízení v obou systémech. Podle jejího výzkumného srovnání optimalizace umožnila silnější záruky soukromí, menší násobitele přidávaného šumu nebo obojí.
Na server se přesunul také výpočet klientských gradientů. Google uvádí, že tím odstraňuje omezení spojená s výkonem zařízení a otevírá cestu k trénování větších modelů federovaným učením. Pro takové budoucí využití považuje za důležité propojení prostředí TEE s akcelerátory.