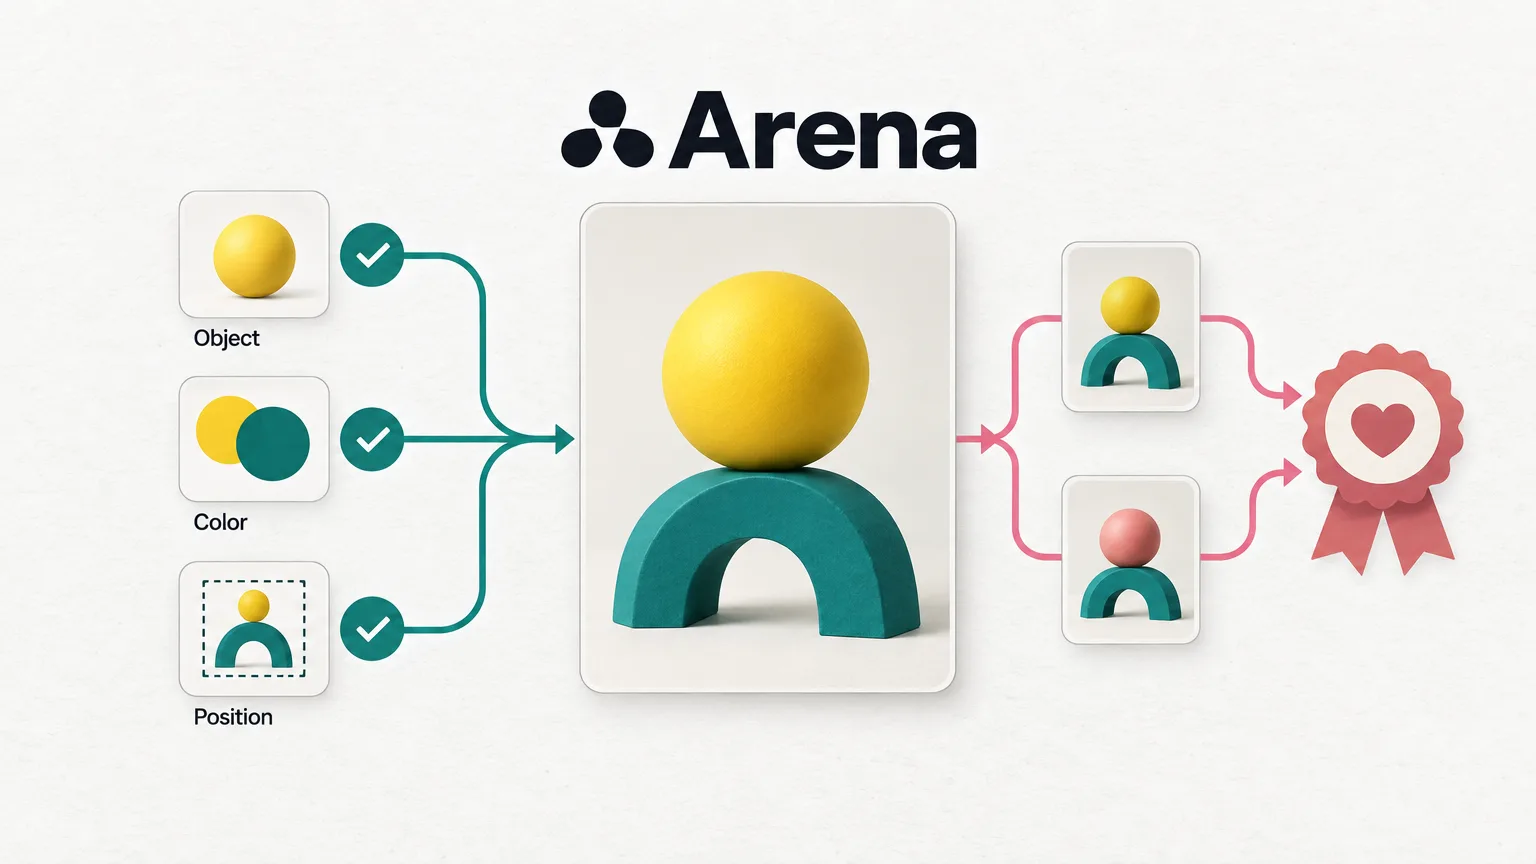
Arena zveřejnila postup dotrénování modelů pro tvorbu obrázků z textu, který propojuje hodnocení lidských preferencí s kontrolou konkrétních požadavků v zadání. Použila ho na FLUX.2-dev a Ideogram 4. Metoda při trénování hodnotí nejen vizuální stránku výsledku, ale také přítomnost požadovaných objektů, jejich vlastnosti a vzájemné vztahy.
Lidské preference doplňují otázky ke každému promptu
Základem preferenčního hodnocení je model Bradley–Terry, který Arena podle svého popisu vytrénovala na přibližně pěti milionech lidských hlasů. Data pocházejí z párových porovnání výstupů více než 100 modelů v Text-to-Image Arena. Hodnoticí model odhaduje, který ze dvou obrázků by člověk upřednostnil, a převádí tento odhad na skóre zachycující vizuální kvalitu, kompozici a estetiku.
Vedle toho Arena pro každý trénovací prompt vytváří samostatné hodnocení věrnosti zadání. Jazykový model nejprve rozloží požadavek do stromu konkrétních otázek, na které lze odpovědět ano, nebo ne. Část otázek se týká objektů a jejich vlastností, další kontrolují prostorové vztahy či požadovaný styl. Vizuálně-jazykový model následně posoudí vytvořený obrázek a odměnu určí podíl splněných kritérií.
Podle Areny mají jednotlivá hodnocení význam také při hledání chyb během trénování. Kontrolní seznam ukazuje, na kterém požadavku obrázek ztratil odměnu: zda například chyběl objekt, nesouhlasila jeho vlastnost, nebo nebyl dodržen prostorový vztah.
Přísnější kontrola se řídí záměrem zadání
Další část postupu Areny kontroluje obsah, který odporuje uživatelovu záměru. Zaměřuje se na nežádoucí objekty, změny požadovaného stylu i porušení negativních instrukcí, tedy požadavků na to, co obrázek obsahovat nemá. Arena tuto kontrolu zapíná pouze u promptů vyžadujících přísné dodržení zadání; u kreativních požadavků ponechává větší volnost.
Detektor omezuje odměnu za známé chyby
Samostatný detektor v trénovacím postupu Areny vyhledává známé způsoby obcházení odměny. Patří mezi ně zkomolený text nebo nechtěný posun k fotografickému vzhledu. Jeho úkolem není přidělovat další kladné body, ale zasáhnout do preferenčního skóre u výstupů, které označí za problematické.
Arena u takto označeného obrázku omezí preferenční skóre nejvýše na nulu. U ostatních vzorků zůstává původní hodnota beze změny. Detekovaný problém tak nemůže získat kladnou preferenční odměnu díky estetice nebo kompozici.
Rozsah této kontroly je omezen na zdokumentované typy selhání. Nové způsoby obcházení odměny vyžadují doplnění kritérií nebo vytvoření dalších detektorů.
Model Soups spojuje varianty do jediného modelu
Arena také popisuje trénování několika variant s odlišnými konfiguracemi odměn. Všechny vycházejí ze stejné výchozí verze modelu. Metodou Model Soups pak průměruje změny jejich parametrů vůči tomuto společnému základu, místo aby při generování nechávala běžet několik modelů vedle sebe.
Podle Areny společná výchozí verze modelu udržuje změny parametrů vzájemně sladěné. Výsledkem sloučení je jediný model bez dodatečných nákladů na souběžný provoz více modelů při generování. Arena zároveň uvádí, že stejný postup lze použít i s open-source modely odměny, například Pickscore.
Výsledky proti základu a v živém žebříčku
Pro trénování Arena použila 10 000 skutečných uživatelských promptů a dalších 1 000 vyhradila pro vyhodnocení. V offline testu působil jako rozhodčí Gemini-3.5-Flash: každý dotrénovaný výstup porovnával s výstupem zmrazeného základního modelu. Dvojice hodnotil v obou pořadích prezentace, aby omezil vliv pořadí na výsledek.
V tomto automatickém hodnocení dosáhla podle Areny konfigurace s kontrolami podmíněnými záměrem promptu 64,2 % výher proti základnímu modelu. Po sloučení parametrů se podíl zvýšil na 66,0 %, tedy o 1,8 procentního bodu. Rozhodnutí v tomto testu přiděloval Gemini, nikoli lidští hlasující.
V živém žebříčku, který využívá lidská párová hlasování, Arena uvádí, že dotrénovaný FLUX.2-dev získal o 69 bodů Arena více. Dotrénovaný Ideogram 4 dosáhl podle jejích výsledků 1 224 bodů a k 4. září 2026 se umístil nad všemi veřejně uvedenými open-source modely v tomto žebříčku.
Popsané výsledky pokrývají dva základní modely. Skóre živého žebříčku se mohou měnit s přibývajícími lidskými hlasy a se vstupem dalších konkurenčních modelů.