Anthropic vydal Claude Haiku 5.5, nový malý model určený pro zpracování velkého množství úloh. Poprvé v řadě Haiku mohou uživatelé nastavovat výpočetní úsilí a volit mezi úspornějším provozem a vyššími schopnostmi. Spolu s vydáním firma rozšiřuje vývojářské SDK o beta podporu ovládání počítače a prohlížeče.
Opakované úlohy a pomocní agenti při programování
Anthropic směřuje Haiku 5.5 především k rychlé, opakované práci. Mezi doporučené úlohy řadí vytváření shrnutí a kompakci kontextu, tedy jeho zhušťování. Dalšími oblastmi jsou dotazy do databází a klasifikace. Při programování podle firmy může model fungovat jako podřízený agent pro Opus 5.5 nebo Sonnet 5.5.
Pro úlohy citlivé na rychlost jej firma doporučuje také do živé zákaznické podpory a pro ovládání prohlížeče. Označuje ho za svůj dosud nejrychlejší model při porovnání standardních rychlostí jednotlivých modelů; Opus v režimu Fast Mode však podle Anthropicu běží rychleji.
Ovládání počítače v testu OSWorld 2.1
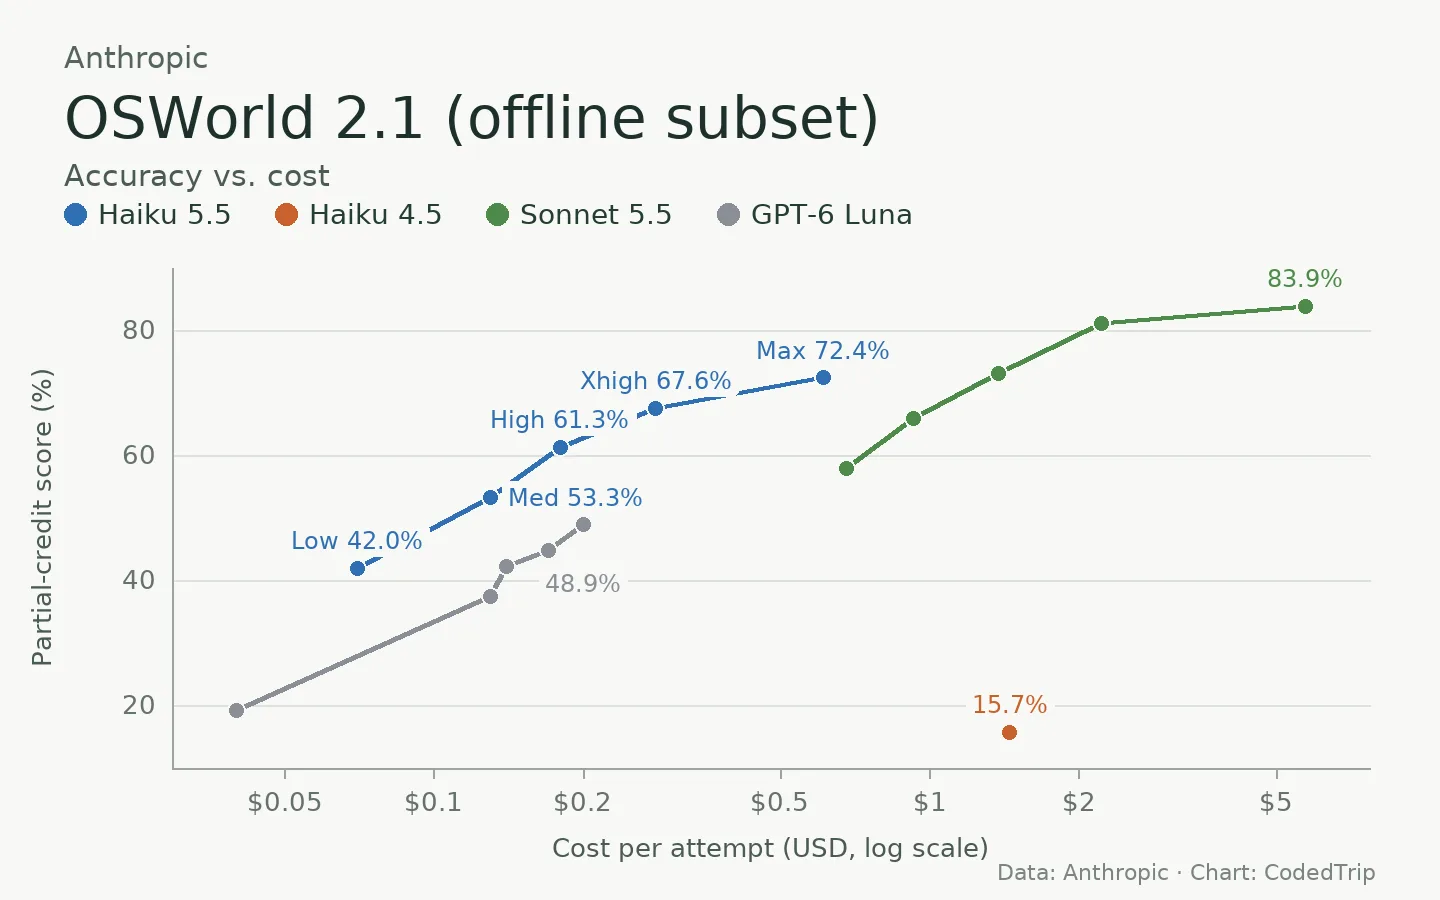
V porovnání zveřejněném Anthropicem dosáhl Haiku 5.5 v offline podmnožině OSWorld 2.1 výsledku 72,4 %, zatímco předchozí Haiku 4.5 získal 15,7 %. Firma tento benchmark popisuje jako test schopnosti agentů ovládat skutečný počítač při dlouhých úlohách složených z více kroků.
Ve stejném porovnání Anthropic uvádí pro GPT-6 Luna skóre 48,9 %. Haiku 5.5 jej v této offline podmnožině překonává, ale zůstává za Sonnet 5.5, který dosáhl 83,9 %.
Znalostní práce a hranice při složitém programování
Také v benchmarku GDPval-AA v2.1 přináší zveřejněné porovnání Anthropicu vyšší skóre než u předchozí verze: Haiku 5.5 získal 1620 a Haiku 4.5 dosáhl 735. GPT-6 Luna má v tomto testu 1437, zatímco referenční Sonnet 5.5 získal 1840.
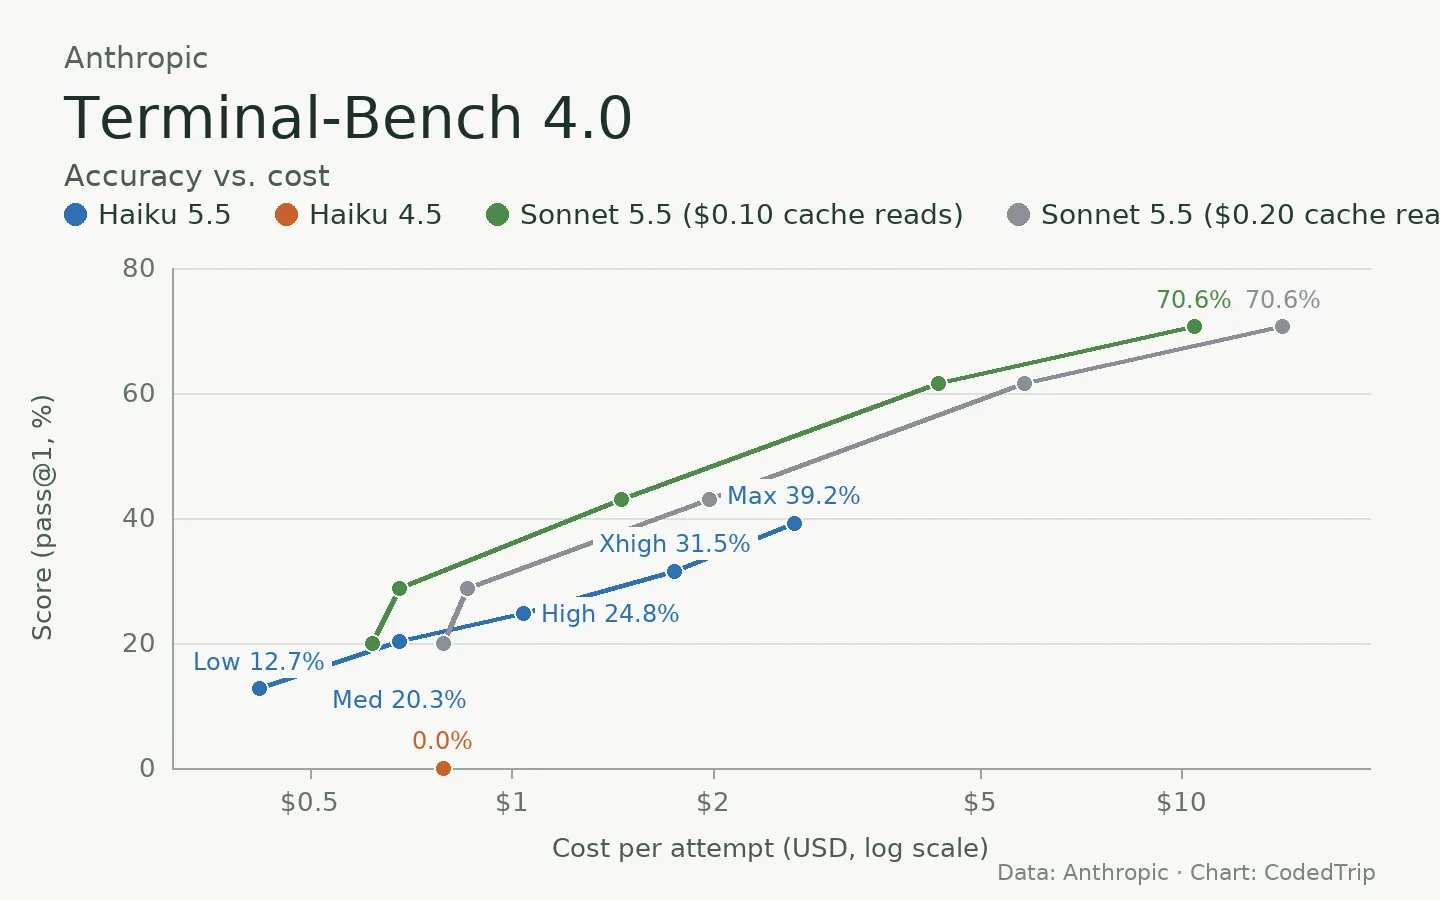
Pro programátorské agenty uvádí Anthropic výsledky Terminal-Bench 4.0. Ten podle firmy hodnotí dokončování složitých profesních úloh o více krocích v prostředí příkazové řádky. Haiku 5.5 zde dosáhl 39,2 %, oproti 0,0 % u Haiku 4.5 a 16,4 % u GPT-6 Luna; Sonnet 5.5 získal 70,6 %.
Pro složité agentní programování proto Anthropic nadále doporučuje Sonnet 5.5 a Opus 5.5. Haiku podle firmy lépe odpovídá úžeji vymezeným úkolům.
| Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 For reference | |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 | 72.4% Offline subset | 15.7% Offline subset | 48.9% Offline subset | 83.9% Offline subset |
| Humanity’s Last Exam | 45.9% no tools | 10.2% no tools | — | 56.9% no tools |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (Main) | 46.4% | — | 42.4% | 52.1% Xhigh |
| Chartography | 46.4% no tools | 6.4% no tools | 29.1% no tools | 61.6% no tools |
Dostupnost v cloudech a beta podpora v SDK
Claude Haiku 5.5 je dostupný na všech platformách včetně Amazon Web Services, Google Cloud a Microsoft Azure. Vývojáři na Claude Platform jej mohou používat pod identifikátorem claude-haiku-5-5.
Aktualizace Claude SDK pro Python a TypeScript přidává podporu ovládání počítače i prohlížeče v beta verzi.
Podle Anthropicu vychází provoz v průměru přibližně o 75 % levněji než u Haiku 4.5: ceníkové sazby jsou o 90 % nižší u požadavků do 100 000 tokenů, kam spadalo 90 % požadavků předchozího modelu, a o 50 % nižší nad touto hranicí, přičemž průměrný výpočet zohledňuje nový tokenizer, kvůli němuž Haiku 5.5 spotřebuje na stejnou práci mírně více tokenů.
Omezení kyberbezpečnostních a biologických úloh
Anthropic uvádí, že kyberbezpečnostní ochrany jsou přísnější než u Haiku 4.5, ale dovolují širší okruh obranných úloh než ochrany Sonnet 5.5. Nadále blokují penetrační testování a další techniky, u nichž firma považuje zneužití útočníky za pravděpodobnější.
V biologii podle firmy platí stejné ochrany jako u Sonnet 5, Sonnet 5.5 a Opus 5: výzkumné dotazy jsou povolené, požadavky vyhodnocené jako pravděpodobně škodlivé omezené. Organizace s širšími potřebami v biologii či kyberbezpečnosti mohou žádat o účast v Life Sciences Verification Program a Cyber Verification Program.