Programátoři dnes stále častěji svěřují práci takzvaným AI agentům. Jde o programy postavené na umělé inteligenci, které samy procházejí kód, spouštějí testy a hledají chyby. Takový agent může klidně hodinu pátrat po skrytém problému. Pak ale narazí na překážku, na kterou nestačí, a musí ji předat chytřejšímu modelu. Jindy zase potřebuje část úkolů svěřit jinému modelu, který se na danou věc specializuje.
Právě při tomto předávání se ztrácí spousta času a výpočetního výkonu. Výzkumníci z Nvidie a z dalších pracovišť proto přišli s nápadem, jak tento krok obejít. Modely si nebudou předávat dlouhé texty, ale rovnou svou vnitřní paměť. První metoda předání zrychlila až pětadvacetkrát a druhá metoda s názvem Cache-to-Cache v průměru dvaapůlkrát.
Jak si model pamatuje, co už přečetl
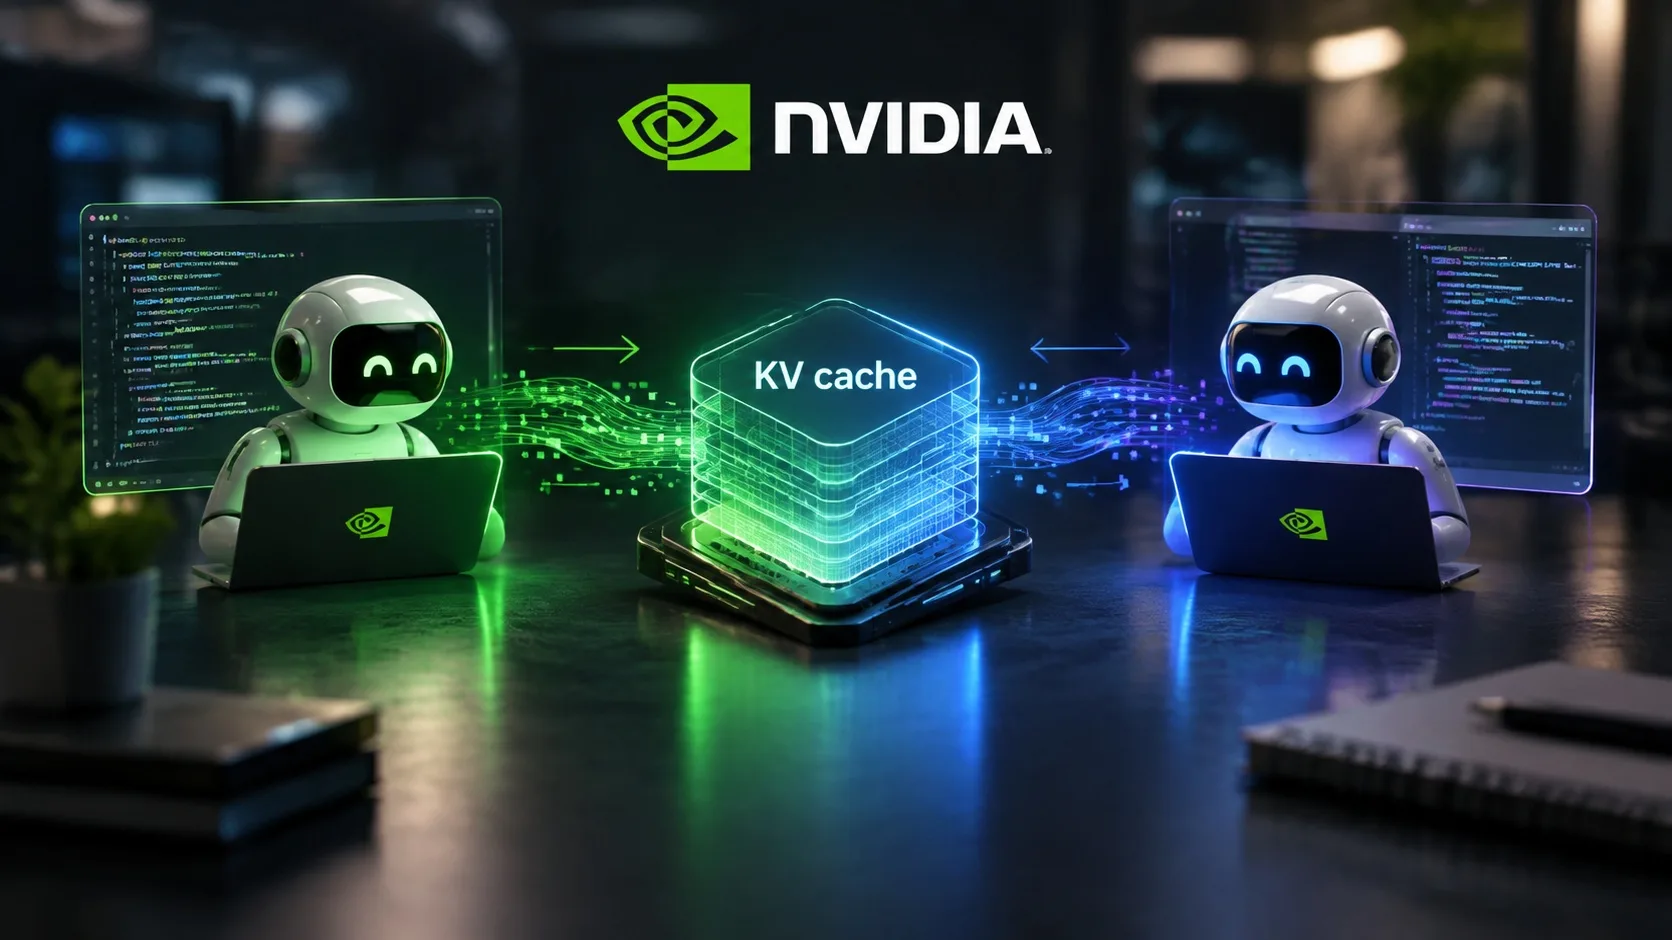
Když jazykový model dostane zadání, nejdřív si ho celé přečte a udělá si k němu vlastní poznámky. Odborně se jim říká KV cache. Pak začne psát odpověď a do těchto poznámek průběžně nahlíží, takže nemusí celý text číst pořád dokola.
Potíž je v tom, že poznámky jsou psané jakýmsi soukromým písmem, kterému rozumí jen model, jenž je vytvořil. Když agent přepne na jiný model, nováček je přečíst nedokáže. Musí proto znovu projít všechno, co se za celou hodinu práce nasbíralo, tedy kód, výsledky testů i dřívější rozhodnutí. Funguje to podobně, jako když v práci převezmete rozdělaný projekt po kolegovi a místo krátkého předání musíte pročíst celý šanon dokumentů.
Když si agent rozdělí práci mezi několik specialistů, vzniká jiný problém. Modely si posílají dlouhé zprávy, které jeden musí pracně napsat a druhý zase znovu zpracovat.
Nvidia překládá poznámky z jednoho modelu do druhého
Nvidia se zaměřila na situaci, kdy agent pracuje s menším modelem a potřebuje přejít na větší a chytřejší model ze stejné rodiny, třeba z menšího Qwen3 na jeho většího sourozence. Místo aby velký model četl vše znovu, vědci jeho poznámky jednoduše přeloží z písma malého modelu do písma velkého. Tento překlad probíhá ve třech následujících fázích.
- Hledání protějšků: systém zjistí, které části malého modelu nejlépe odpovídají jednotlivým částem velkého modelu.
- Úprava pořadí: z poznámek odstraní informaci o tom, kde v textu se které slovo nacházelo, a doplní ji až po překladu. Díky tomu zvládne převést i velmi dlouhé texty.
- Samotný převod: postará se o něj jednoduchý statistický výpočet, který nevyžaduje drahé a zdlouhavé učení umělé inteligence.
Na nastavení celého převodu stačilo vědcům pět set ukázkových textů. Metodu vyzkoušeli na šesti dvojicích modelů z rodin Qwen3, Llama 3.1 a Ministral 3, vždy kombinovali menší variantu s větší. Postup funguje pouze mezi modely stejné rodiny, které mají podobnou architekturu.
Výsledek je výrazný. Převod poznámek k velmi dlouhému textu trval necelou třetinu sekundy. Kdyby si je velký model vytvářel znovu, zabralo by mu to skoro sedm sekund. Rychlost ovšem něco stojí, protože při překladu se část informací ztratí. Velký model si podle typu úlohy zachoval zhruba tři čtvrtiny až téměř všechnu svou běžnou přesnost. Nejhůře dopadly matematické úlohy. Přesnost lze sice vylepšit chytřejším převodníkem, jeho příprava je ale složitější.
Modely se domluví beze slov díky C2C
Druhá technika míří na situaci, kdy dva modely spolupracují. Jeden třeba zkoumá, proč program padá, a druhý mezitím chystá opravu. Normálně by první model musel sepsat zprávu slovo po slově a druhý by ji pak musel přečíst. To trvá a v krátkém shrnutí se navíc snadno ztratí důležité detaily, případně může výsledek vyznít nejasně.
Tuto metodu vyvinul tým vědců kolem Tianyu Fua, představil ji na prestižní konferenci ICLR 2026 a její kód volně zveřejnil. Oba modely si při ní nejprve přečtou stejné podklady a udělají si vlastní poznámky. Pak přijde ke slovu speciální tlumočník, který poznatky prvního modelu převede do podoby srozumitelné pro druhý model a vloží mu je rovnou do jeho poznámek. Nikdo tak nemusí psát ani číst žádnou zprávu. Samotné modely se přitom nijak nemění, učit se musí jen tlumočník. Postup navíc funguje i mezi úplně odlišnými modely, vědci zkoušeli například Qwen, Llamu i Gemmu.
V testech, které prověřují uvažování a znalosti, dopadla tato metoda o několik procentních bodů lépe, než když si modely posílaly textové zprávy. Proti modelům pracujícím samostatně byla přesnější o šest až čtrnáct procent. Rozdíl v rychlosti ukazuje jasné měření. Napsání krátké zprávy trvalo modelu přes sekundu, kdežto předání poznámek přes tlumočníka zabralo zhruba desetinu sekundy.
Ani tato metoda nemá jen výhody. Tlumočníka je potřeba nejdříve naučit a vědci musí mít přímý přístup k vnitřku modelů. Pokud je model, od kterého poznámky pocházejí, slabší nebo špatně zvolený, může toho druhého svést na scestí. Obě techniky tak mohou využít jen firmy, které mají modely plně ve svých rukou. Kdo používá umělou inteligenci pouze přes uzavřené služby velkých firem, k jejímu vnitřku se nedostane. V pokusu, kde spolu dva agenti řešili matematické příklady, nakonec nejlépe dopadla kombinace obojího, kdy si modely předaly krátké vysvětlení slovy a k tomu i své poznámky.